◉ TL;DR
量化交易就是用數據做你的「交易導航」。
它幫你擺脫情緒猜測,用數字驗證市場規律。
量化交易框架 lo2cin4bt 簡化數據處理與回測流程,讓不懂編程的你也能在半天內嘗試量化交易。
而且 lo2cin4bt 從數據獲取到績效可視化一應俱全,並支援美股與加密貨幣市場。
本文將會完整展示回測流程。
你準備好脫離韭菜了嗎?
◉ 如何下載 lo2cin4bt?
前往代碼倉庫 GitHub ,點選右上角的「Code」按鈕,選擇「Download ZIP」下載專案檔案至主機。
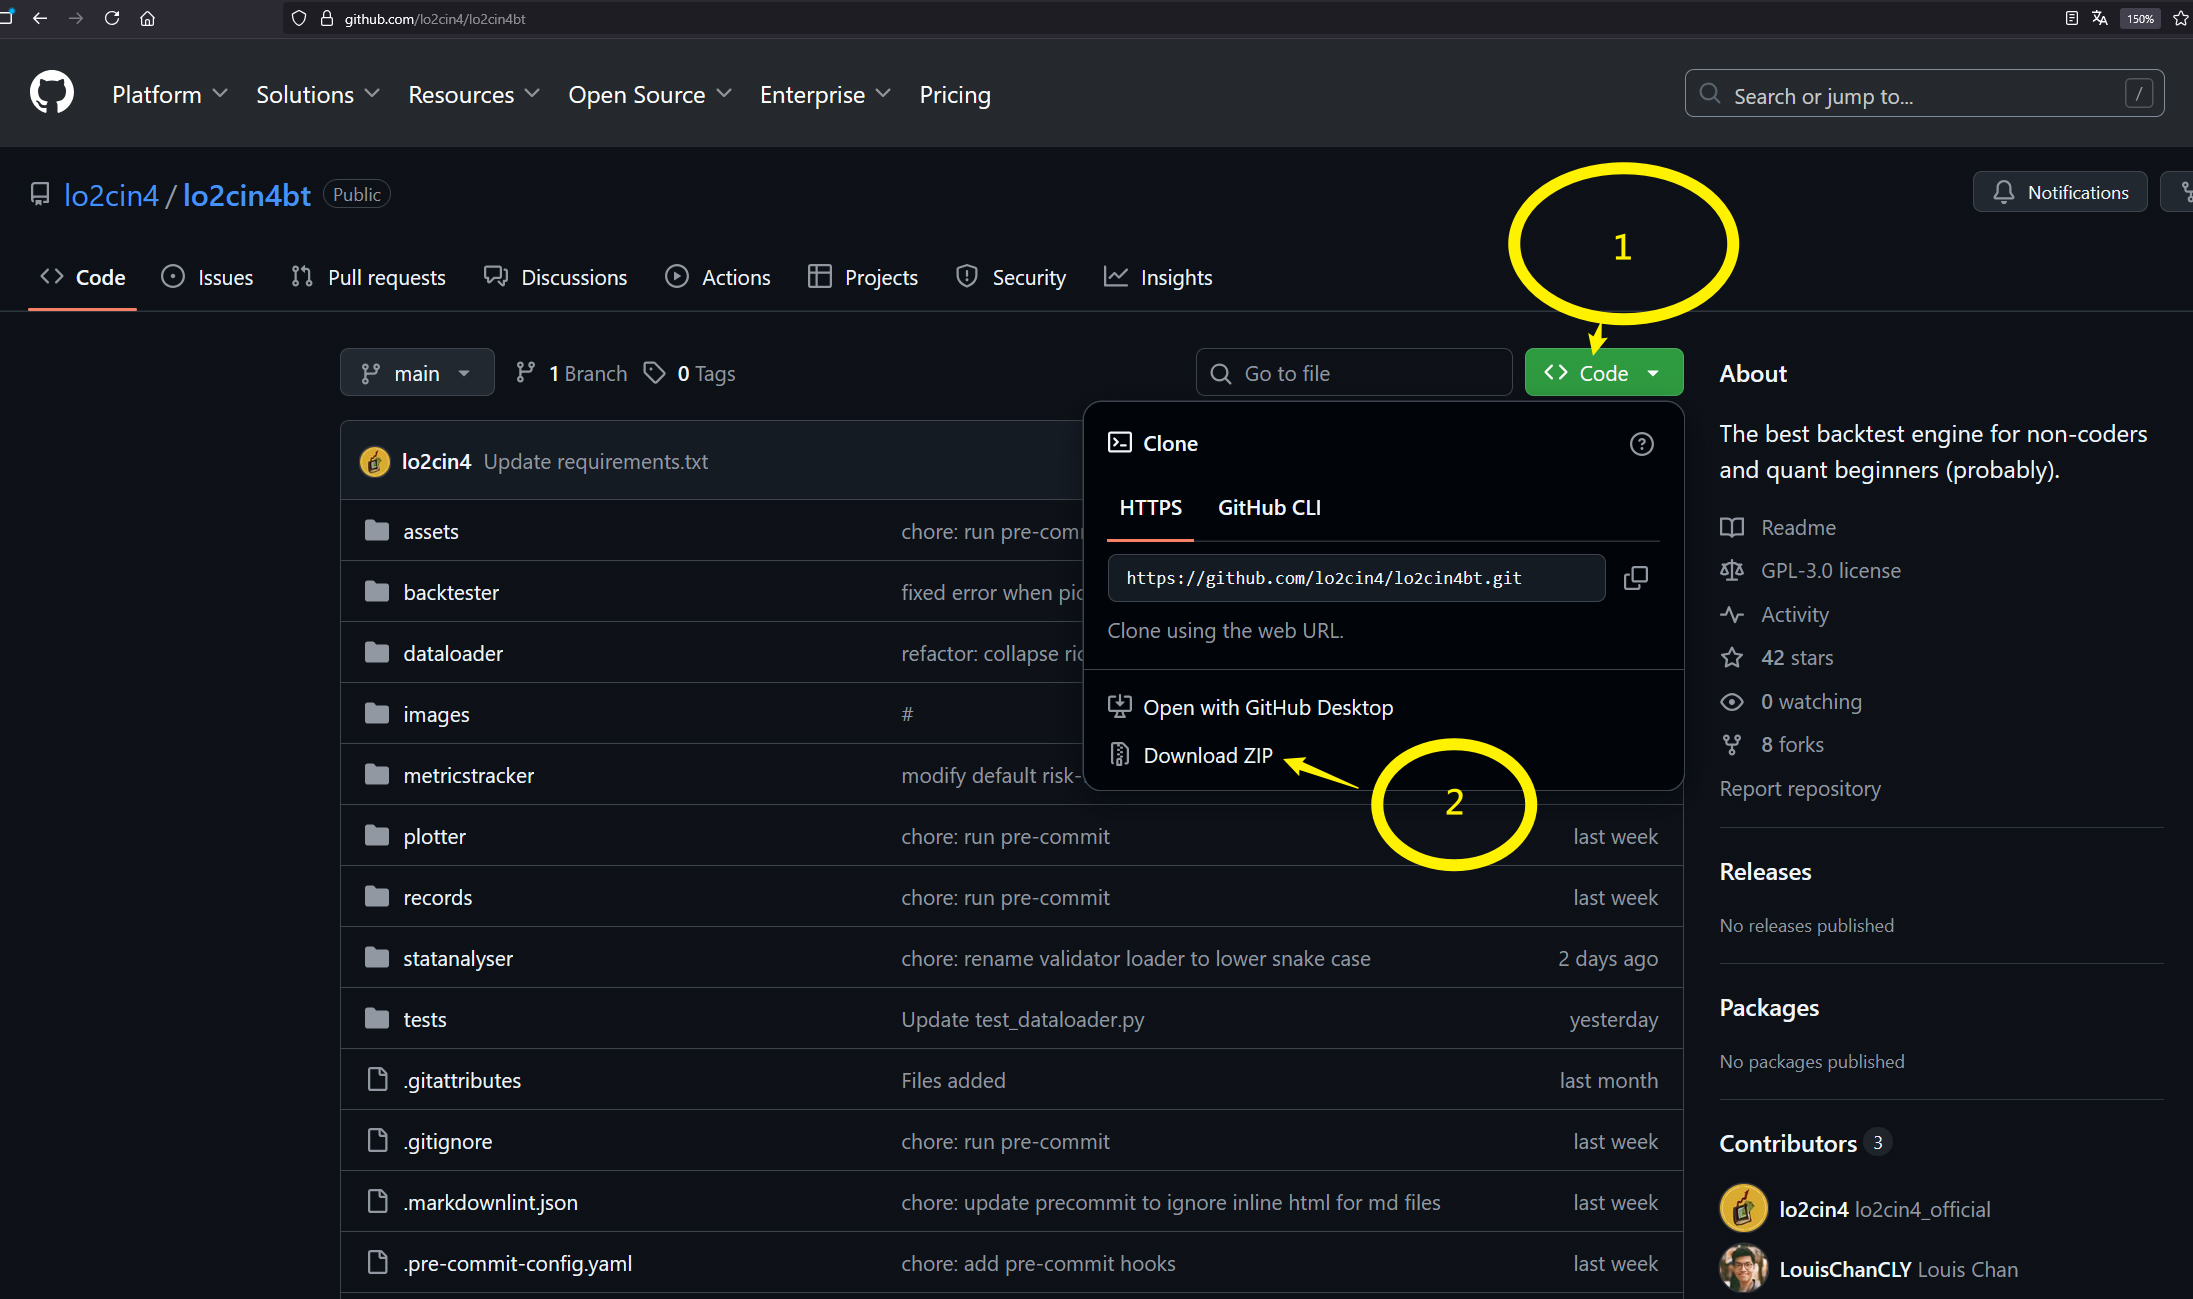
目前使用的框架為 2025 年 12 月 21 日的版本。
解壓縮下載的 ZIP 檔案 lo2cin4bt-main ,並將檔案移動至您指定資料夾,最好放在容量大一點的磁碟。
接著,對於所有不想編程的新手來說,可以安裝 Cursor 或 Antigravity 等免費 AI 編程軟體,之後一切與編程與代碼相關的問題都會由它代勞。
( 留意 Antigravity 需要 VPN )
如果運行回測中途遇到任何問題,也可以詢問 AI 意見。
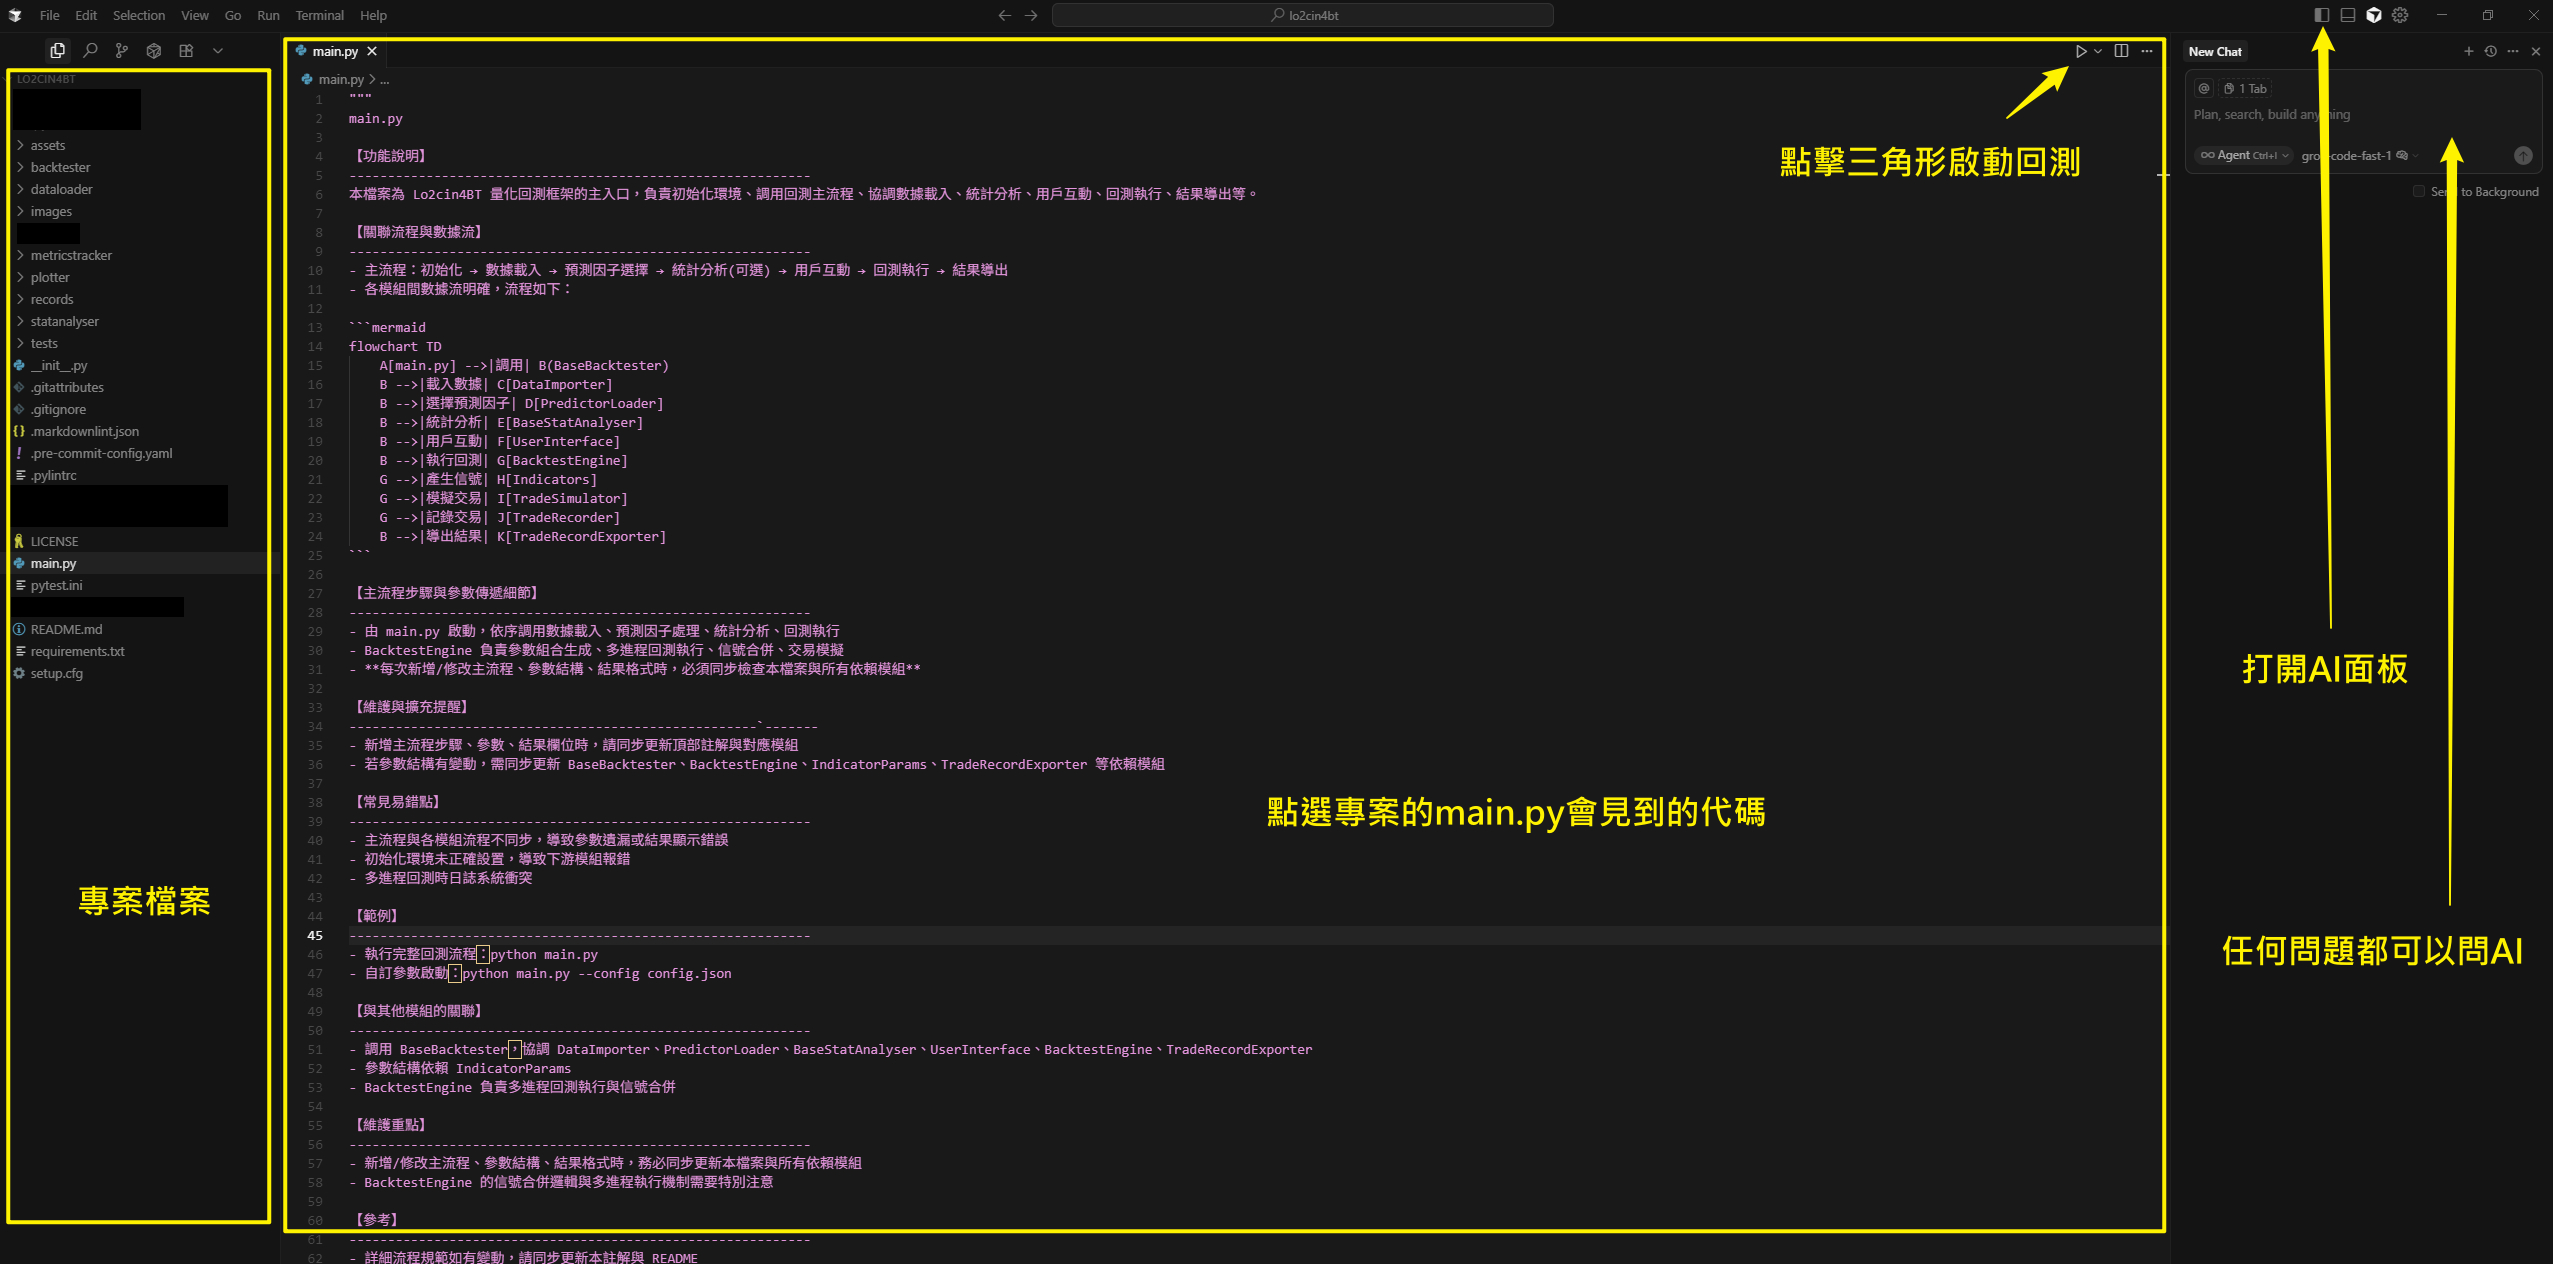
安裝完成後,打開 Cursor 並點擊左上角的 “ File ” → “ Open folder ”,打開剛才的 lo2cin4bt-main ,然後確認。
你應該能看到左側會有整個專案的所有檔案。
接著在右側問 AI :「幫我建立虛擬環境、下載所需程式庫並運行 lo2cin4bt 」。
它會一步步幫你設置環境,安裝所需的程式庫,接著你便可以開始運行。
◉ 找到適合的數據
量化交易需要 2 種數據:
- 資產的歷史價格:
比如比特幣過去的價格走勢。
lo2cin4bt 提供了幣安( Binance )與 Coinbase 的 免費 API,可以直接使用他們的各種加密貨幣歷史價格。 - 預測因子:
比如某個數據能提示價格會漲或跌。
預測因子的獲取渠道則可以參考 btcboxer.com ,此網站綜合了不少數據商連結
新手建議從加密貨幣開始,因為不少數據都是免費公開下載。
取得數據後,需對數據進行初步清理,例如確保數據沒有遺漏值,或格式與要求一致。
清理後,將數據存入 lo2cin4bt/records/dataloader/import 資料夾。
目前 lo2cin4bt 支援 CSV 、 XLSX 和 JSON 格式,數據格式如下:
Time ( DD/MM/YYYY ) | 預測因子 1 | 預測因子 2 …
您可參考 import 資料夾中的 predictor_example 範例檔案。
◉ 開始數據載入
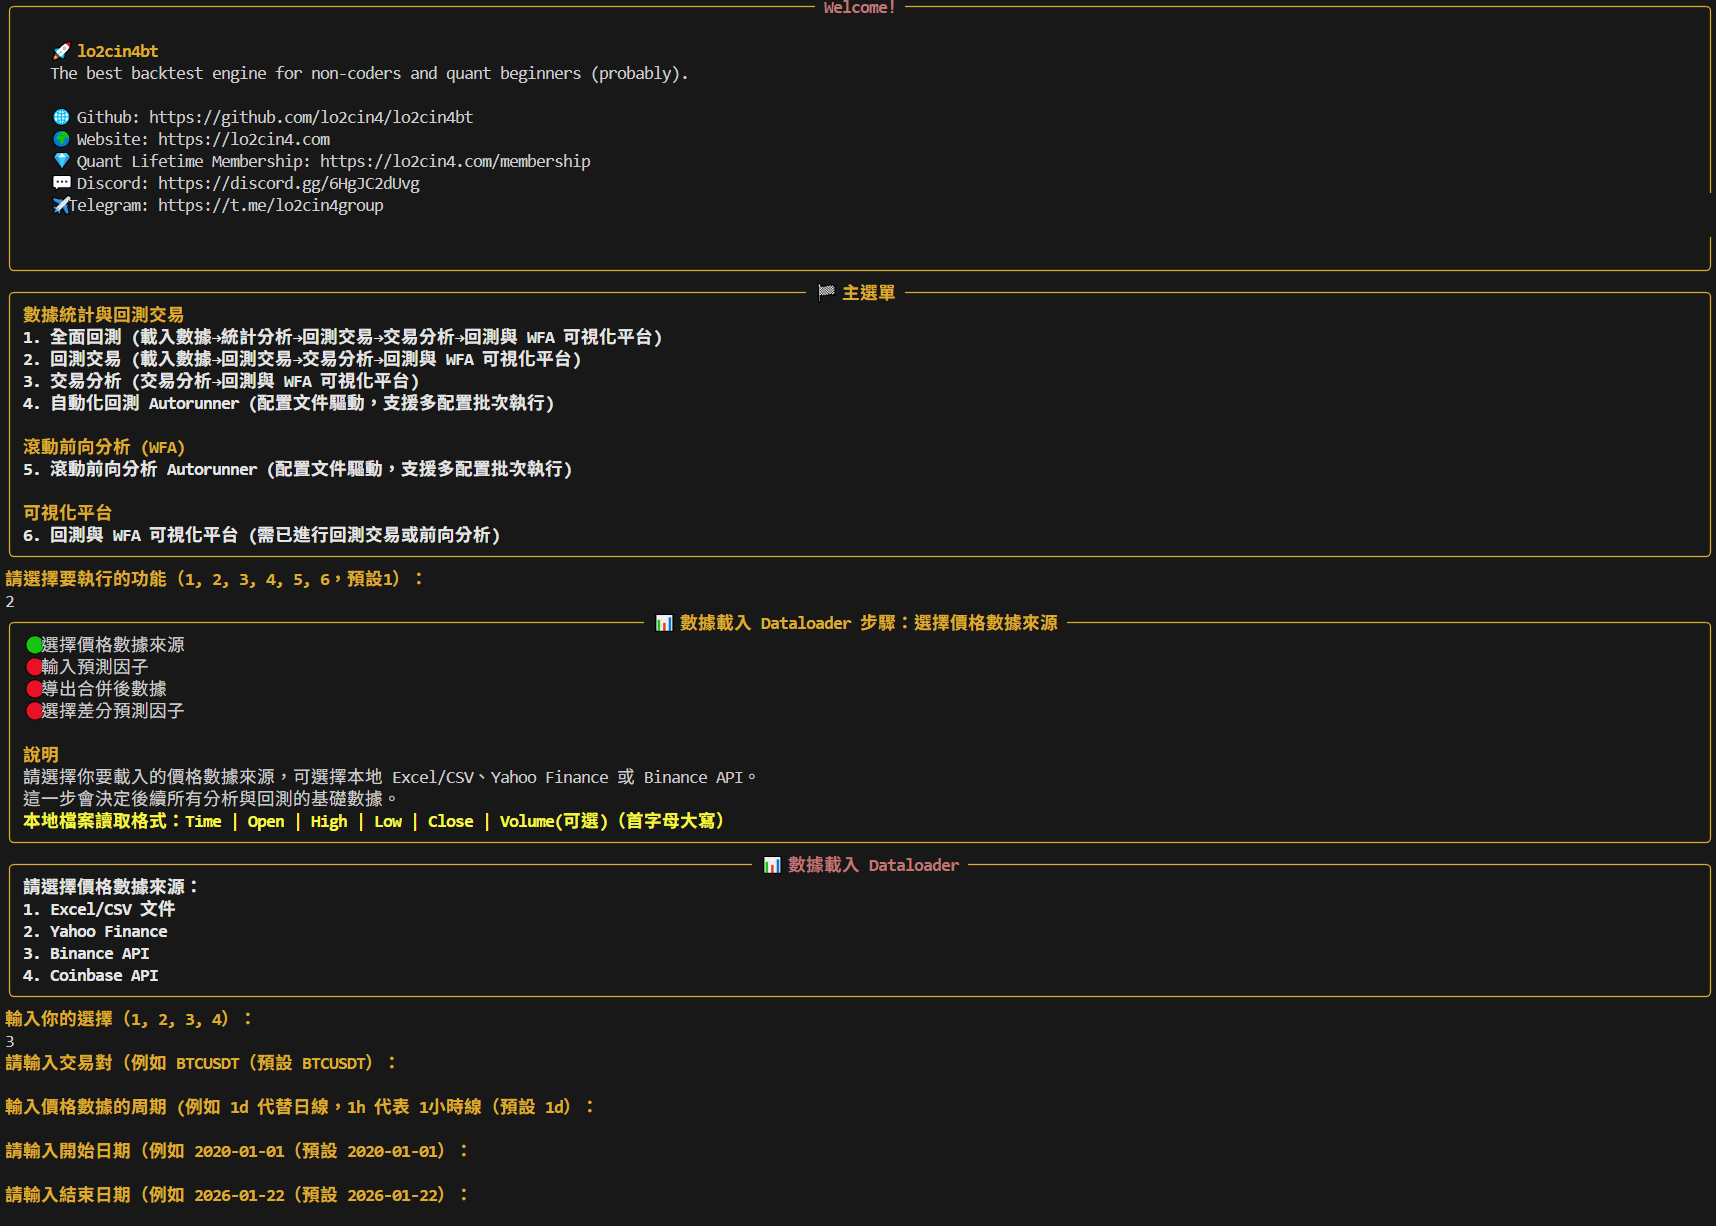
主選單
點擊並打開左側的 main.py 檔案,並按右上角的三角形符號以啟動回測。 ( 參照上圖 )
進入主選單後,可先選擇選項 2 「回測交易」,跳過複雜的統計分析,直接進入數據載入與回測階段。
選擇價格數據來源
回測的第一步是選擇用哪項資產的歷史價格。
目前框架提供以下選項:
- 讀取本機數據
- 透過 Yahoo Finance API 獲取美股數據
- 透過幣安 API 獲取數據
- 透過 Coinbase API 獲取數據
本次我們輸入 3 ,選擇幣安 API。
新手建議:
輸入「 3 」後,如果你是第一次用,可一直留空按 Enter 鍵,系統會自動幫你選擇比特幣( BTCUSDT 交易對)和 2020 年 1 月 1 日到現在的每天價格。
完成後,系統還會計算 BTCUSDT 的每日收益率及對數收益率,以供系統本身使用。
輸入預測因子
接下來要告訴系統,我們將用使用甚麼數據來猜價格走勢。
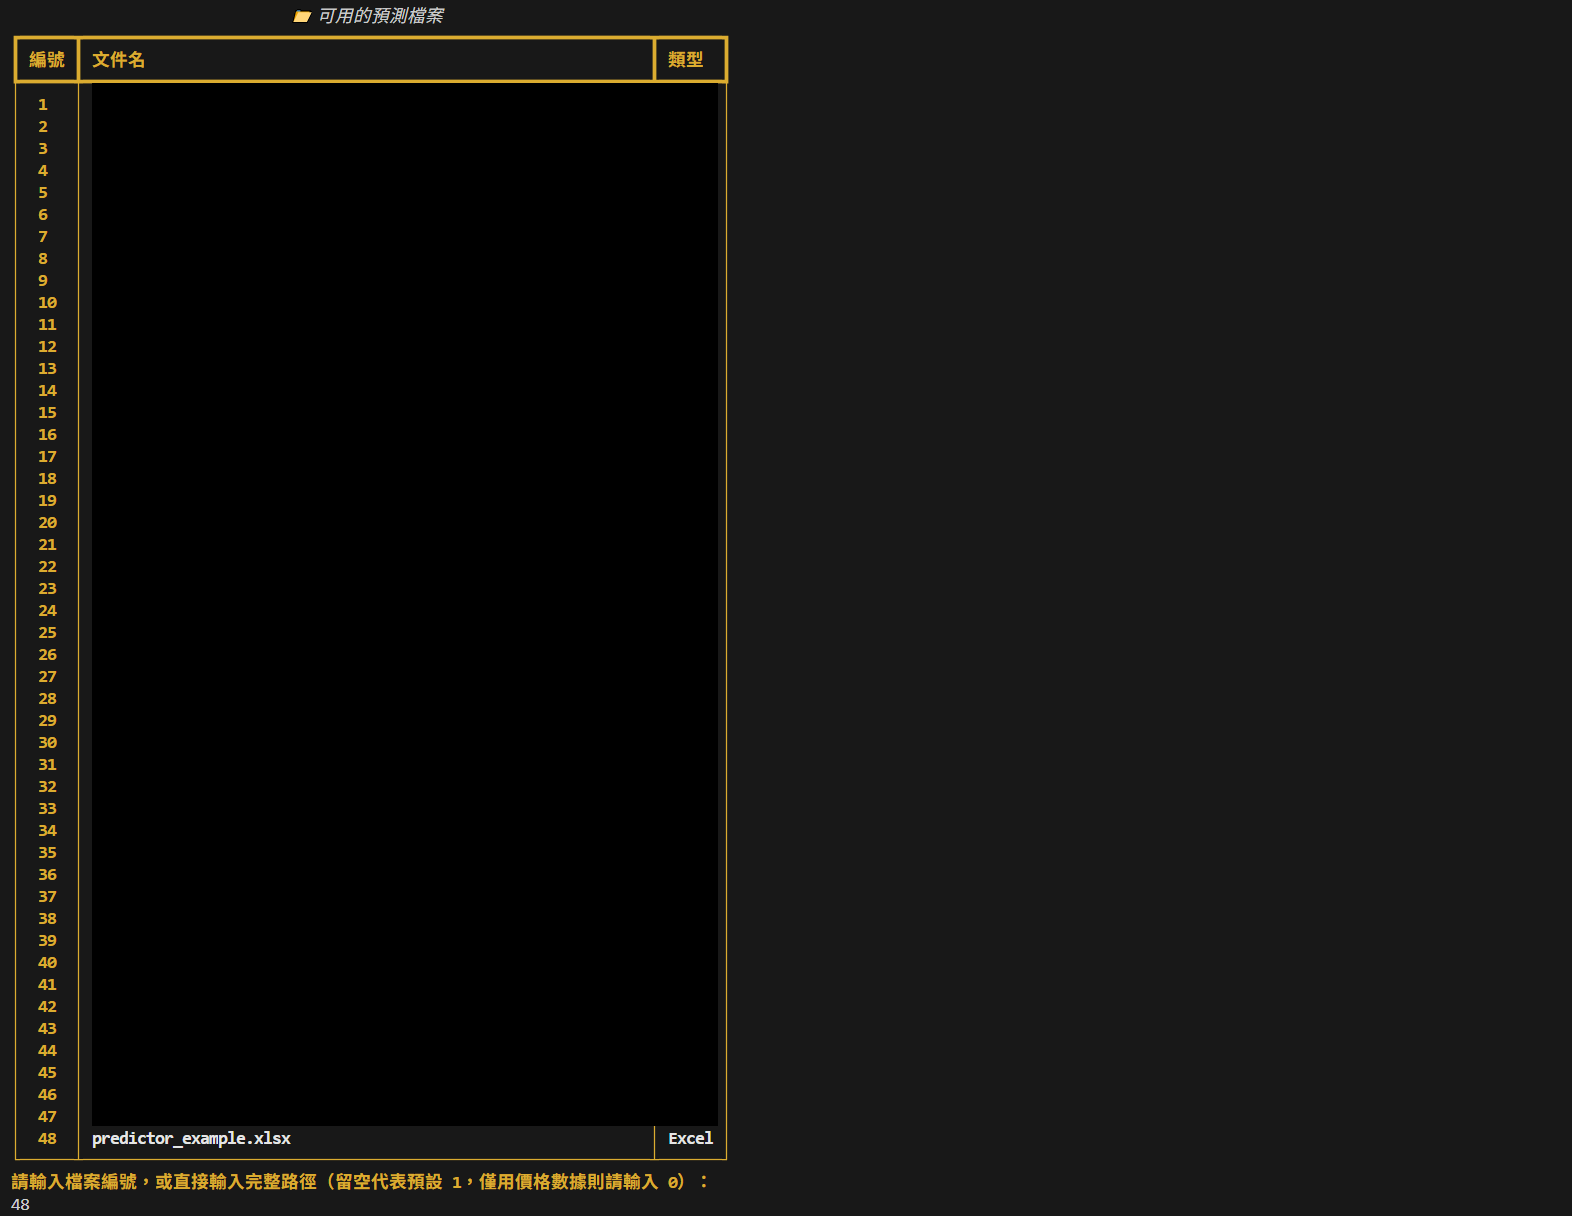
系統會自動檢查 lo2cin4bt/records/dataloader/import 資料夾裡的檔案,列出所有能用的數據文件。
如果輸入數字「 0 」 則會使用原資產的價格數據,也就是常見的「用價格數據本身來進行預測」的策略 。
本次我們選擇附贈文件 predictor_example.xlsx,然後繼續留空 Enter 。
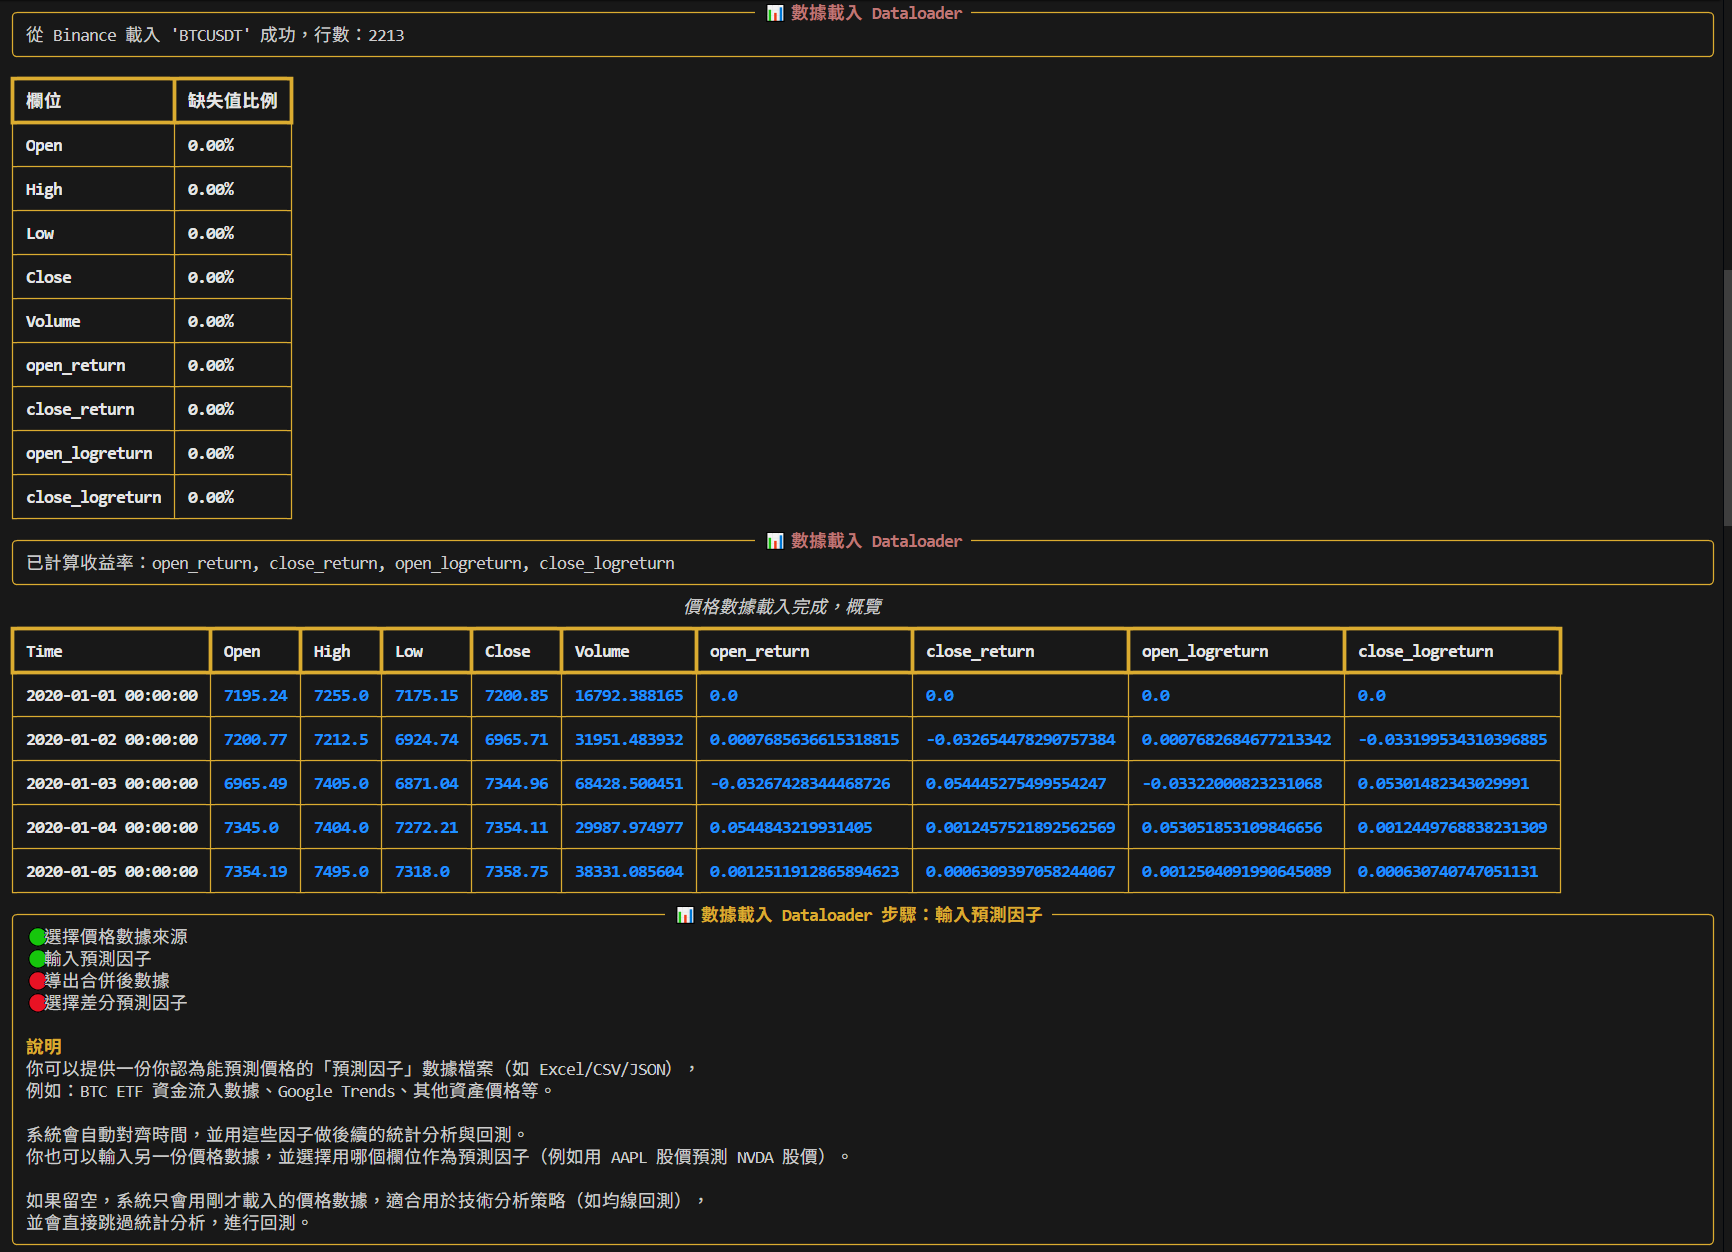
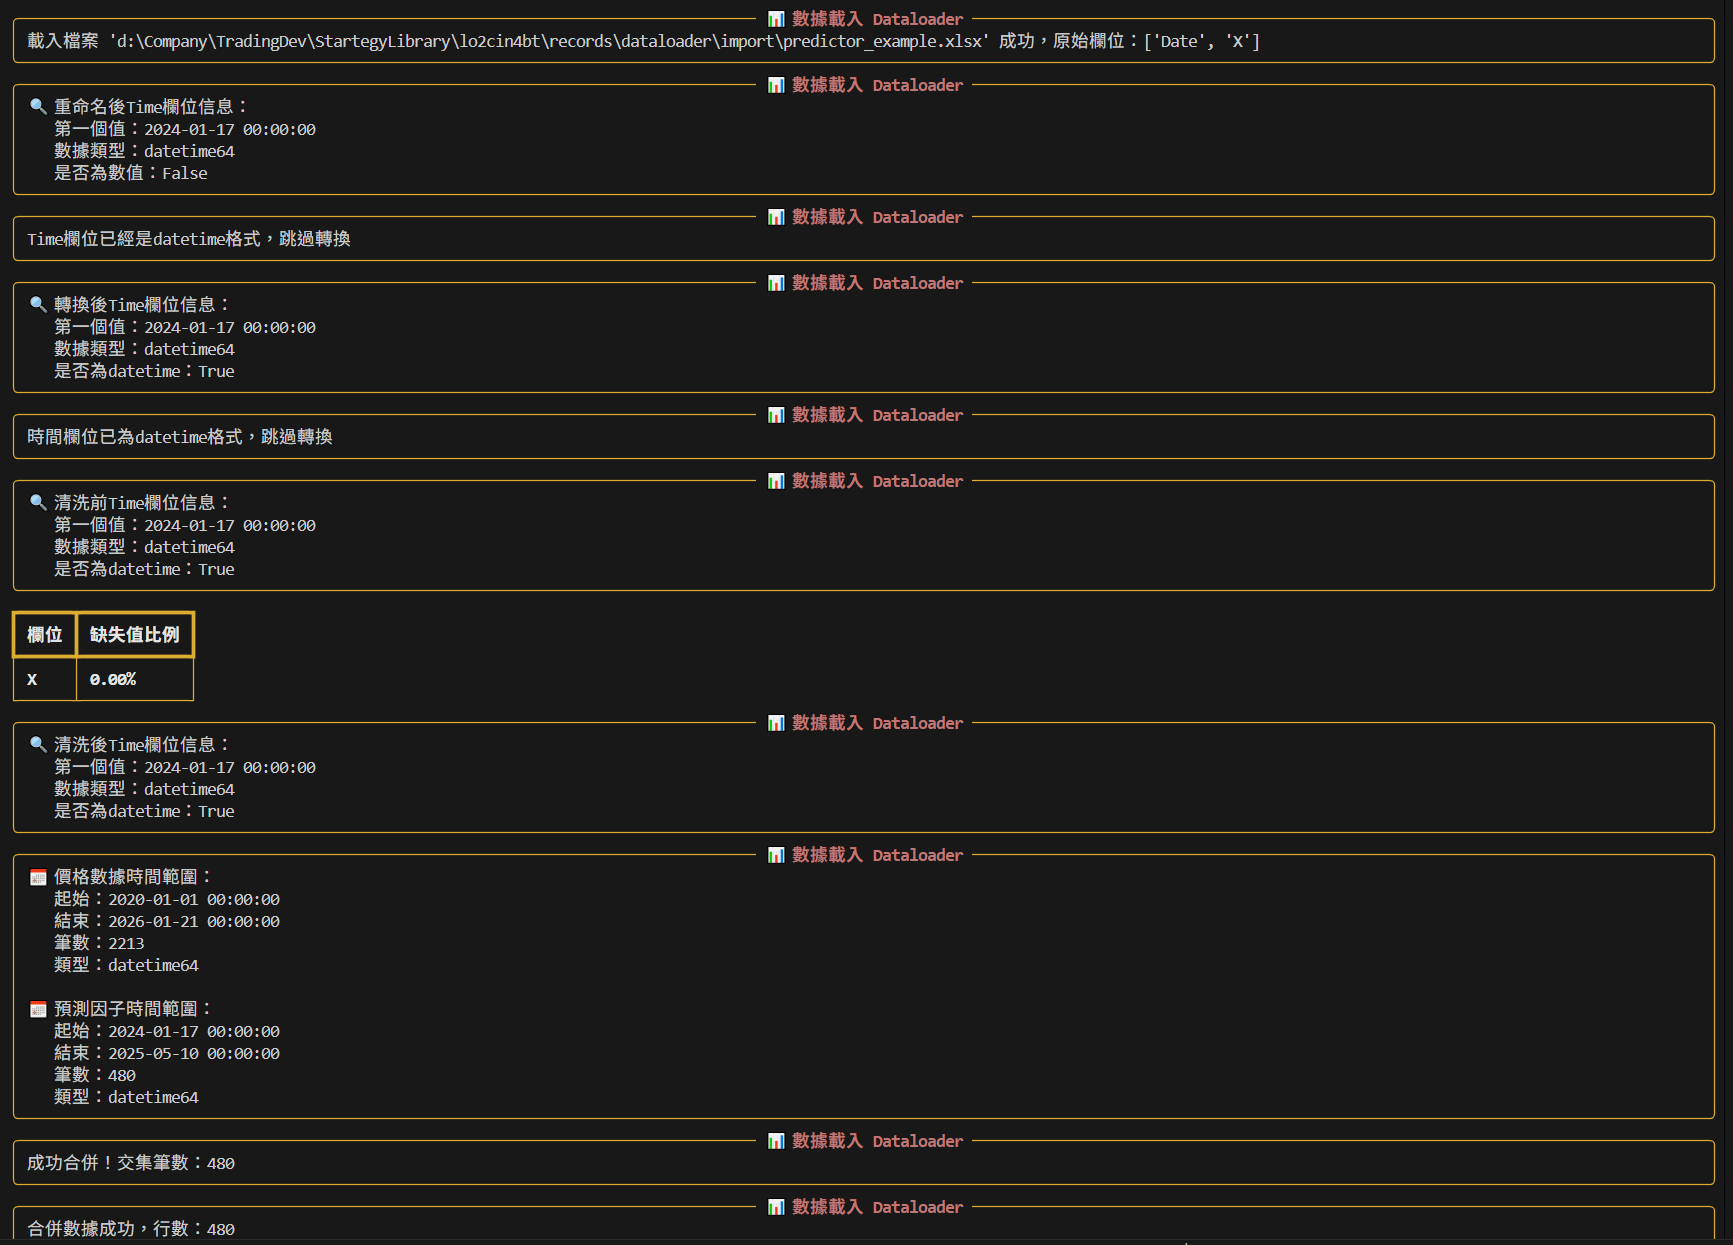
系統將顯示預測數據的基本資訊,包括缺失值比例、數據行數及整合後的數據表格。
如有問題 ( 如有缺失 ),先自行清理原始數據。
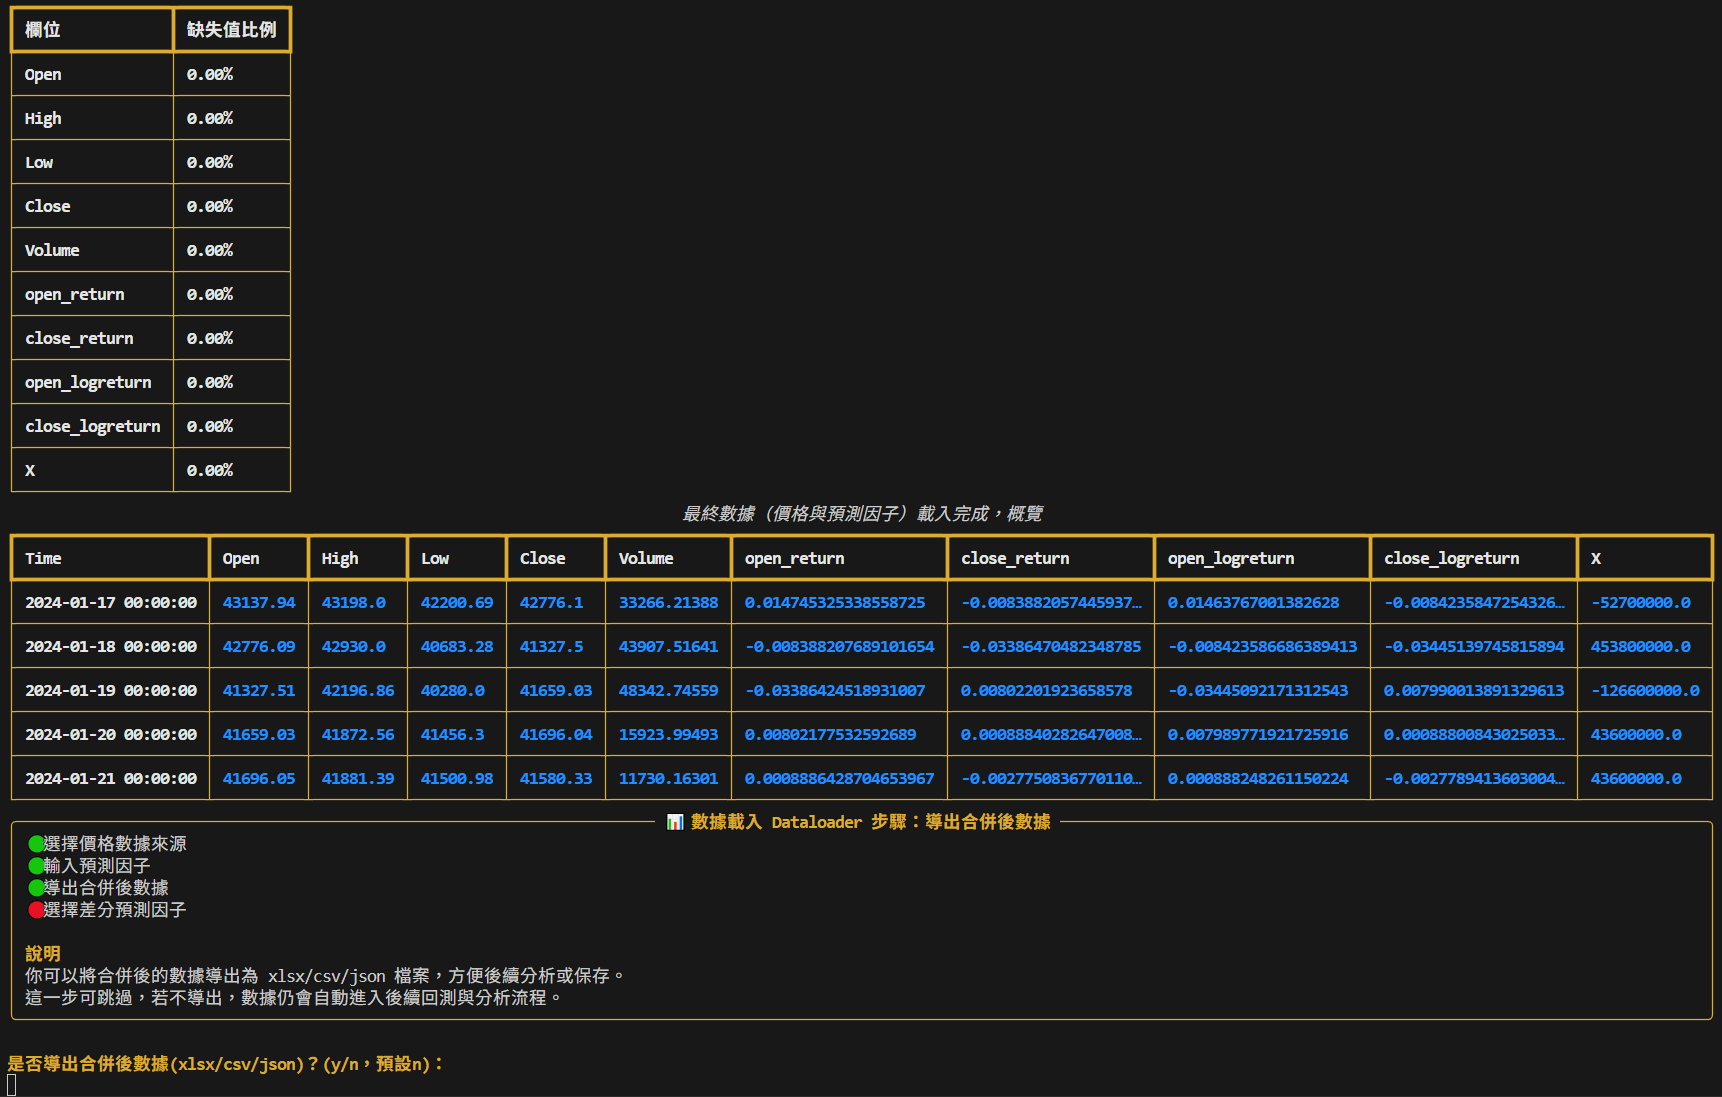
導出合併後數據
你可以把系統合併好的價格 + 預測因子數據庫以 Excel / CSV / JSON 格式導出,並手動檢查確保數據沒問題。
選擇差分預測因子
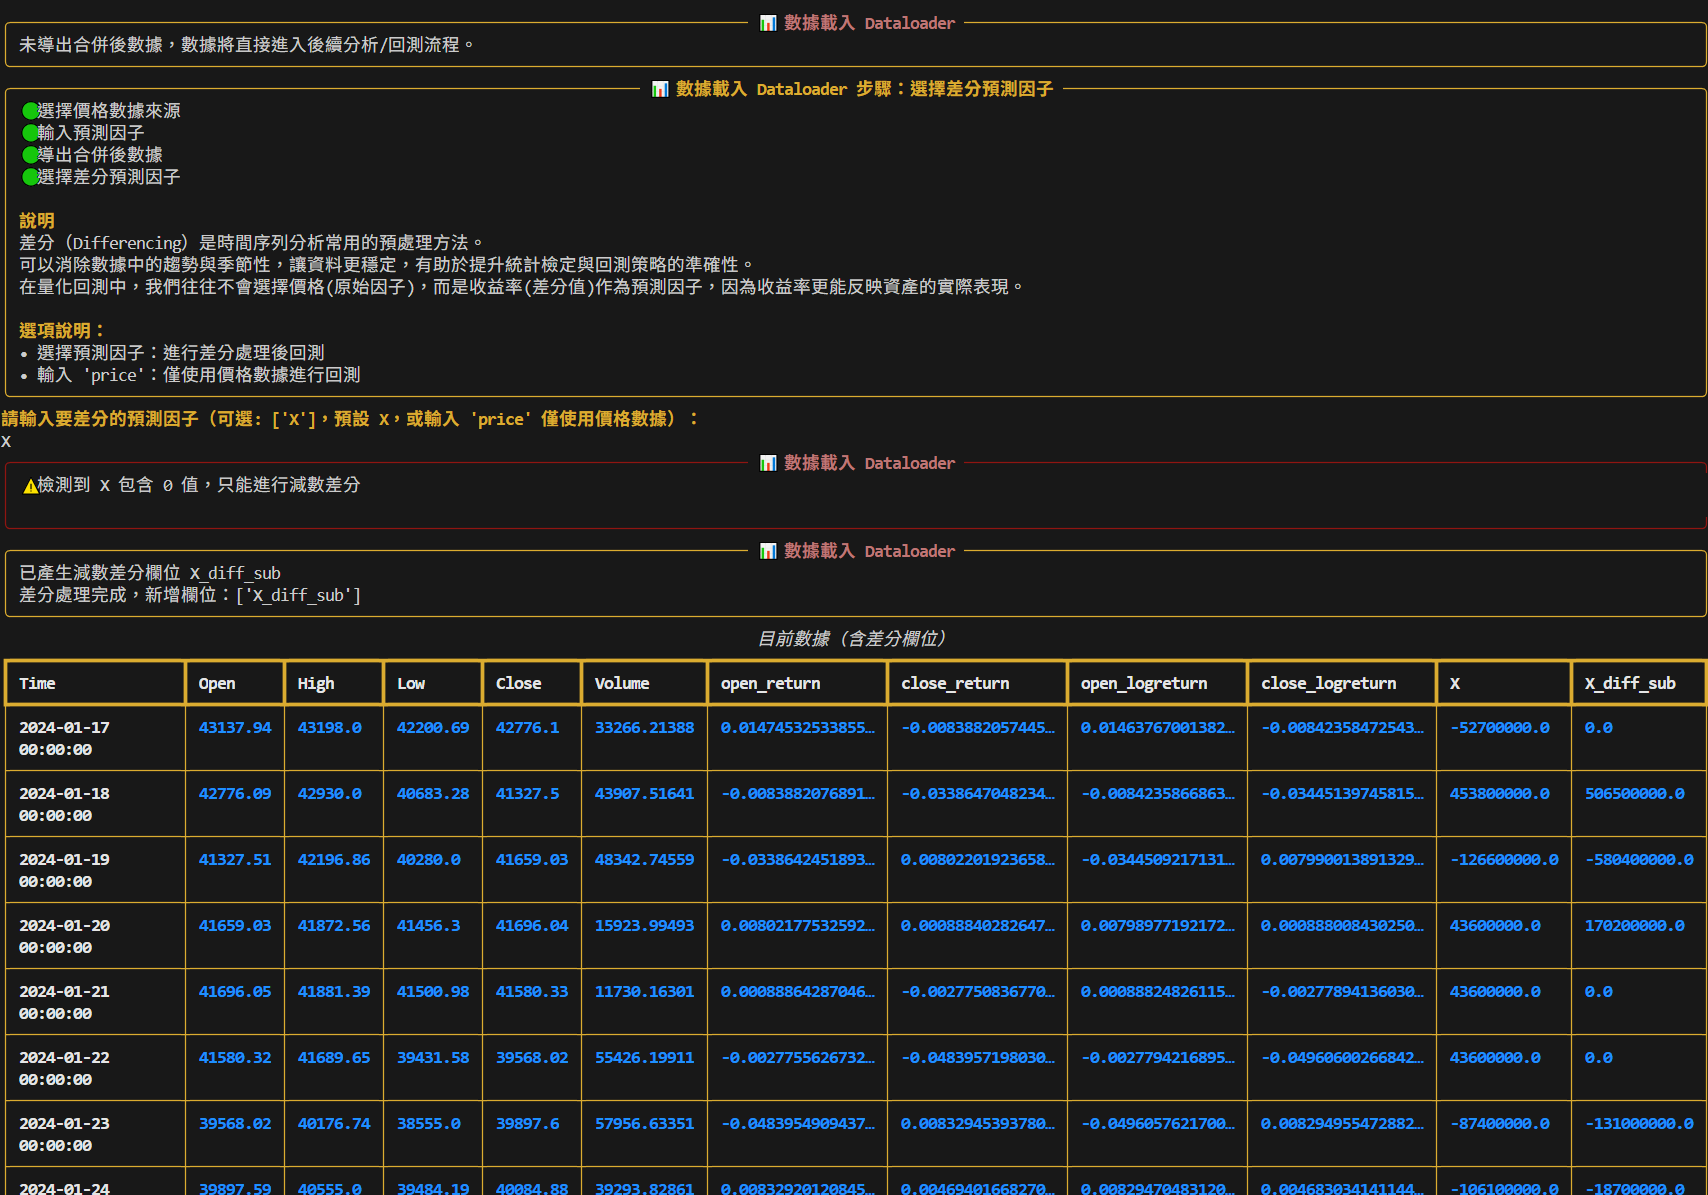
數據整理好後,接下來可以選擇是否加工數據,將其「差分」,讓它更適合預測。
「差分」也就是 rate of change ,是看每兩個數據點之間的變化。
系統目前提供兩種加工方式:
- 減數差分:今天的分數減昨天的分數,得到變化量
- 除數差分:算今天比昨天漲了或跌了百分之幾 ( 如有零值將會只運行減數差分 )
當你認為原始數據之間的變化率,比原始數據本身更具預測價值的時候,便可以計算差分。
例如檢測某數據單日升 10% 的時候,是否代表之後會漲。
如果你對差分值沒有需求,這一步做不做都不會影響後面操作。
◉ 進入回測分析部份
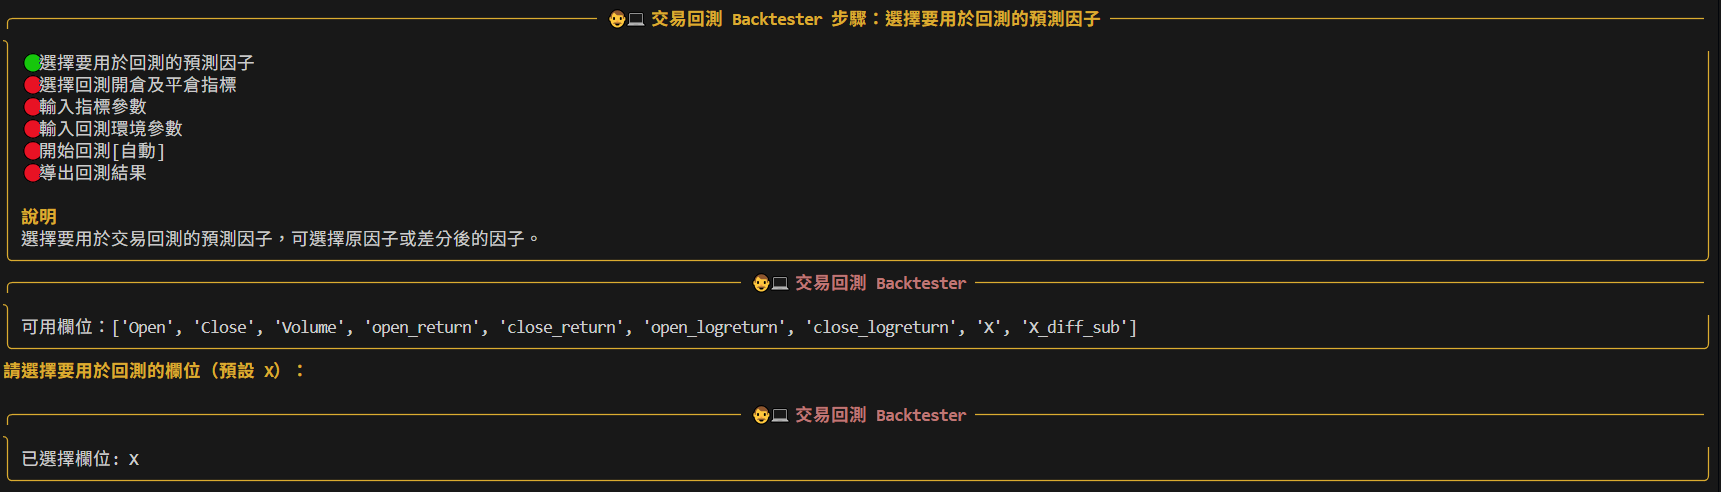
選擇要用於回測的預測因子
接著是重頭戲,建立策略並用數據測試你的交易想法!
系統現在會列出剛選中的檔案裡的所有欄位。
輸入想驗證的數據所在欄,如本次會使用「X」,然後 Enter 。
選擇回測開倉及平倉指標
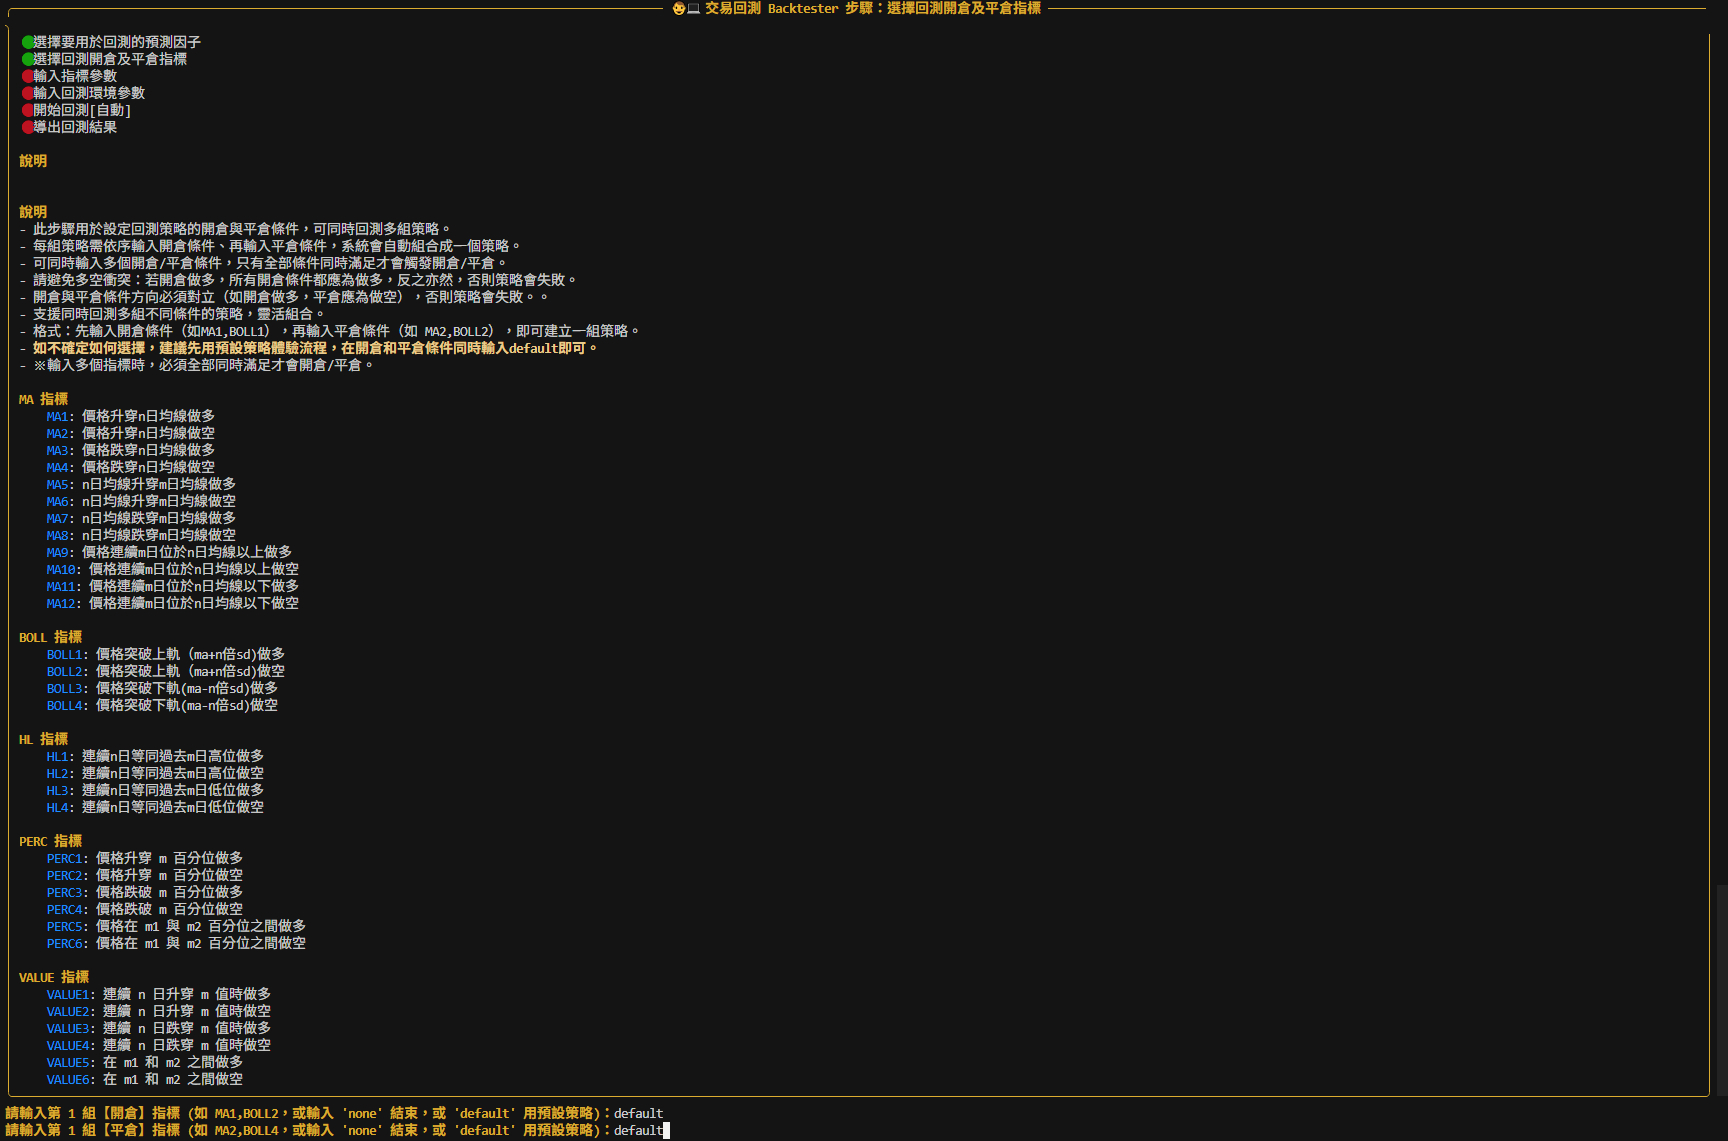
這一步是回測的核心,你需要建立策略,並輸入對應的開倉和平倉指標。
比如,策略一是輸入「 MA1 」作為買入信號,再用「 MA4 」當賣出信號;
策略二是輸入「 BOLL1 」作為買入信號,再用「BOLL4 」當賣出信號。
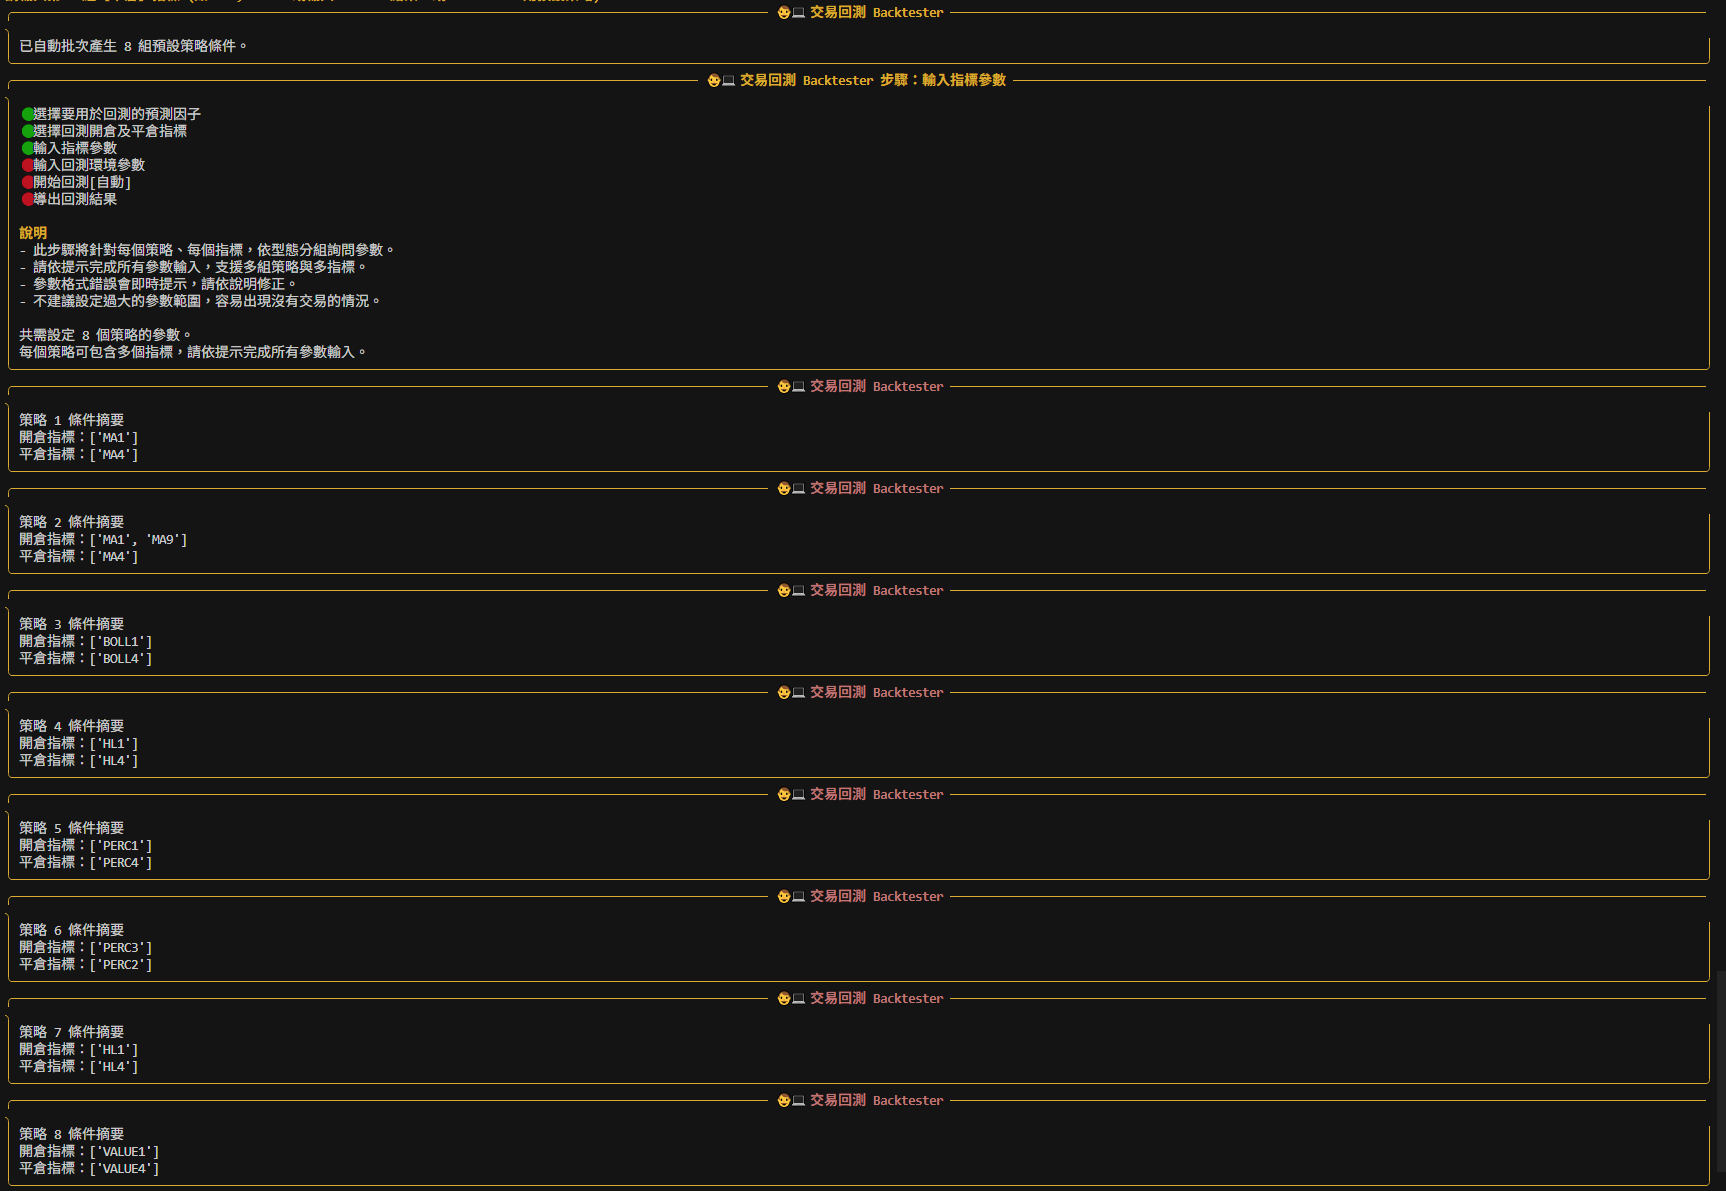
然後我們就建立了兩個策略:
「X 升穿前幾天的平均值時買比特幣,並在 X 跌破平均值時賣出」和
「X 升穿前幾天的保力加通道頂部時買比特幣,並在 X 跌破保力加通道底部時賣出」
無論是開倉還是平倉條件,你都可以輸入多個指標,讓交易信號變得更嚴格。
例如可以同時輸入 「MA1」和「MA9」作為開倉信號,那就需要同時滿足兩者時才開倉。
當你已經建立好所有想測試的策略後,便可以按指示輸入 “n” 或 “none” 結束建立策略。
新手建議:
- 在開倉和平倉條件同時輸入「 defaultall 」,便可以用預設策略。
輸入指標參數
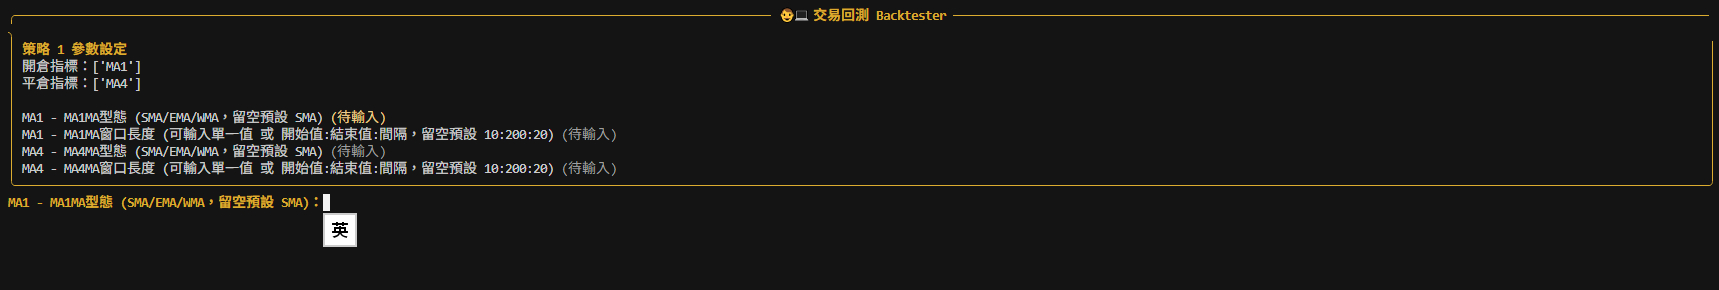
完成建立策略後,便開始為各策略輸入各指標參數。
比如, MA1 的「過去幾天」可以設成 5 天、 10 天,或更多。
你可以輸入單個數字(像 10 ),或用「開始:結束:間隔」格式(像 5:20:5 ),之後系統便會測試同一指標但不同參數的表現。
我亦為大家設好預設值,只需留空 Enter 便可。
新手建議:
- 留空按 Enter 用預設值。
輸入回測環境參數
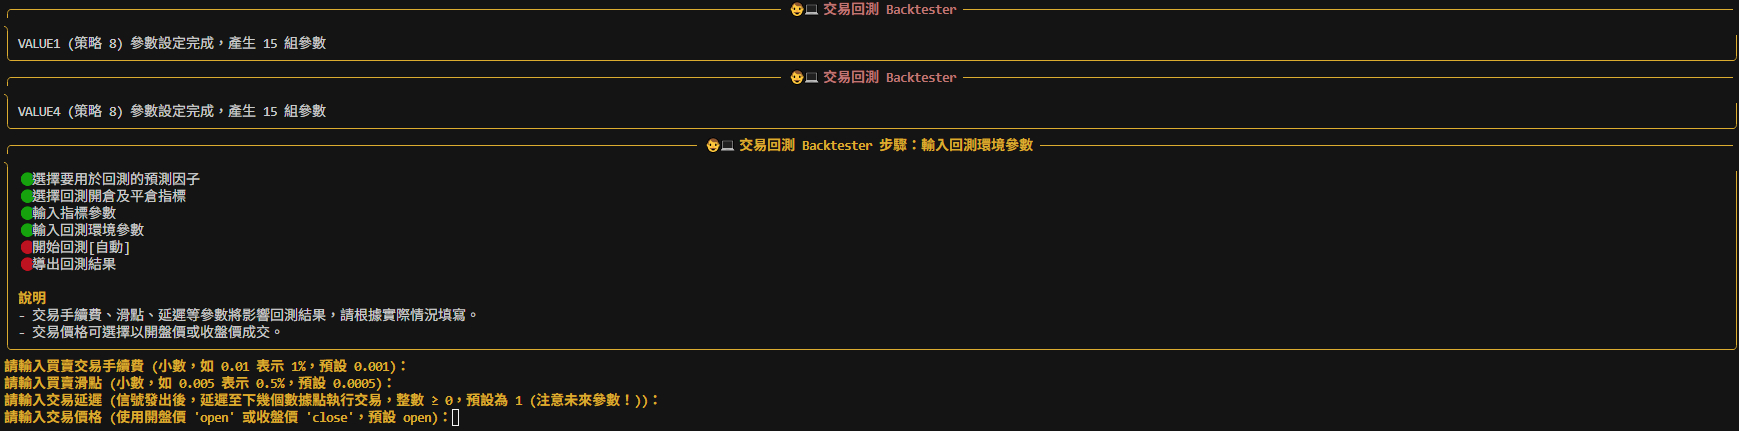
這一步是設定模擬交易的環境。
你需要告訴系統:
- 手續費:交易所的「過路費」,留空輸入的話預設為 0.1% 。
- 滑點:買賣時價格可能有點偏差,預設 0.05% 。
- 交易延遲:信號出來後要等多久才買賣,預設為 1 天,盡量避開未來函數的問題。
- 交易價格:用開盤價還是收盤價,預設為開盤價,結合交易延遲,那就是當信號發生時,在翌日的開市價交易。
未來函數是指程式碼使用了未來的數據來進行當前的決策。
簡單來說,就是你的交易系統「偷看」了未來的價格或資訊,來決定現在要不要買賣。
例如某數據在收盤後才公佈,但你卻設了無延遲交易,那系統就會用了未來才公佈的數據,但用了收盤價交易。
這種情況在真實交易中是不可能發生的,因為沒有人能預知未來,而採用了未來函數的回測表現往往超級漂亮。
為了避免此問題,我們會將交易延遲至翌日開市,甚至翌日的收市價。
新手建議:
- 留空 Enter 用預設值。
開始回測
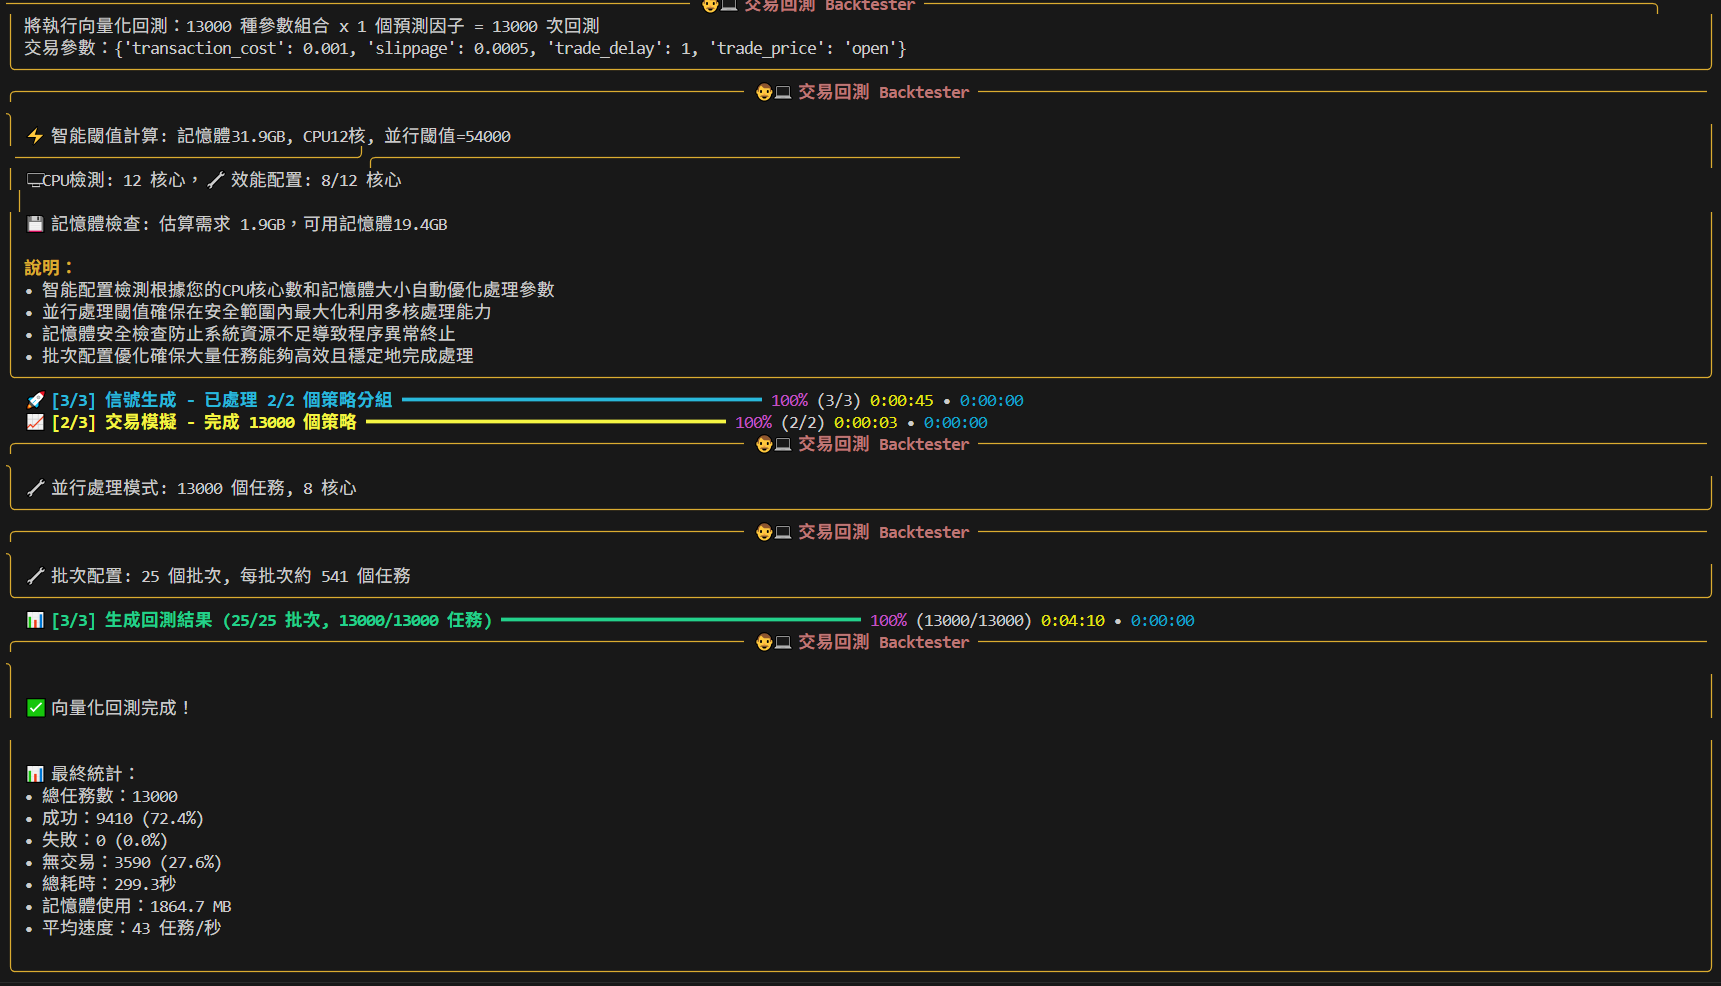
一切設定好後,系統會告訴你總共要試多少個策略,再按 Enter ,系統就會開始跑回測。
系統會自動檢查你的硬件設備,並且安排效率最高的回測方法。
除非是超大量的回測 (如幾萬個策略 ),否則需時應該不會超過 10 分鐘。
以我已用了快十年的電腦為例,跑三年數據,13000 個策略,不到 5 分鐘可以出結果。
導出回測結果
回測完成後,系統會顯示回測結果統計,包括成功、失敗或無交易的回測情況(無交易通常是參數設得太嚴格)。
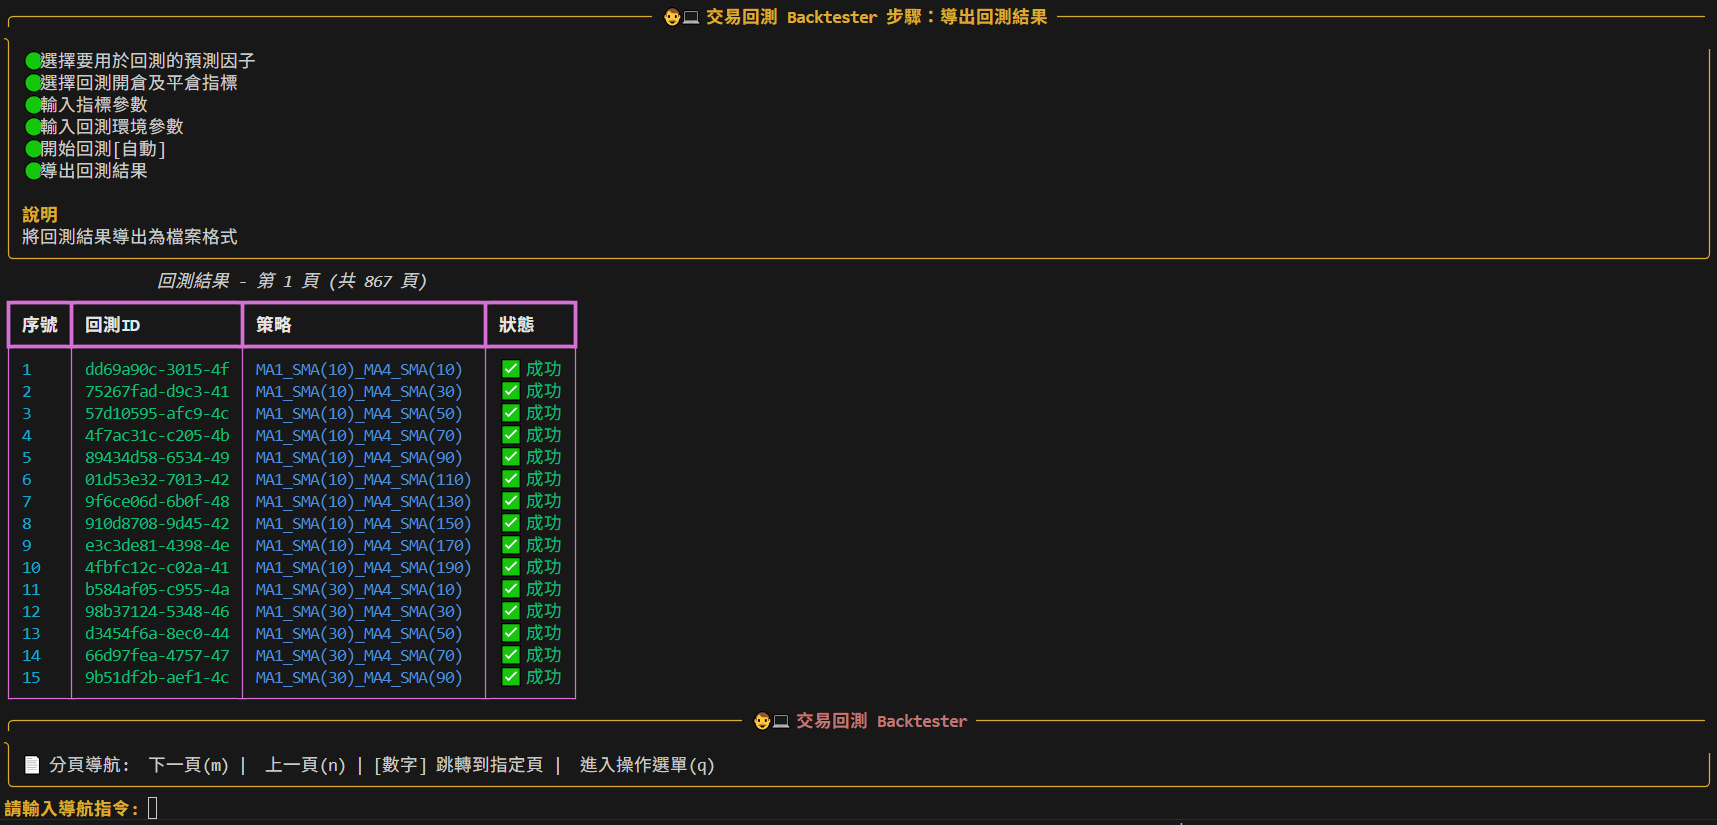
然後,系統會再以表格形式,列出每個策略的回測 ID 及參數。
你可輸入「 m/n 」翻頁,或輸入數字跳至指定頁面。
確認無誤後,輸入「 q 」進入操作選單。
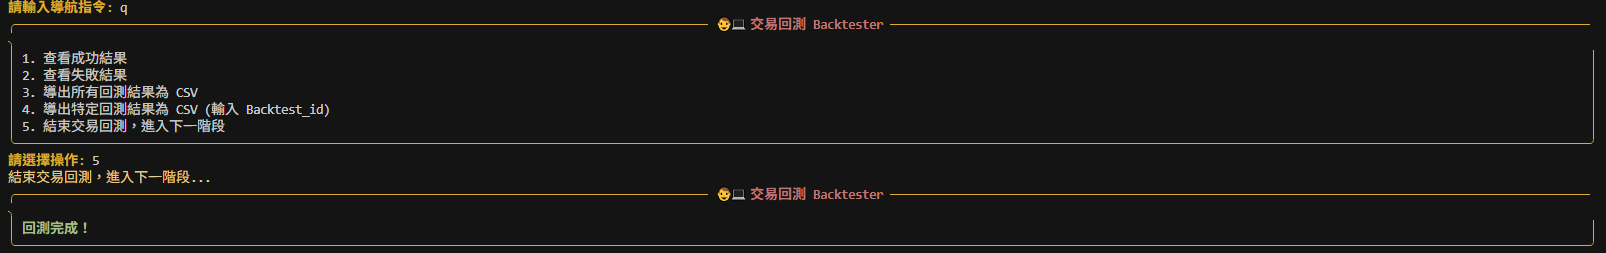
常用選項包括:
- 選項 3 :將所有策略結果導出為獨立 CSV 檔案,方便檢查回測有沒有問題。
- 選項 5 :進入策略績效計算階段。
 新手建議:
- 輸入” 5 ” 進入下一步。
◉ 計算績效
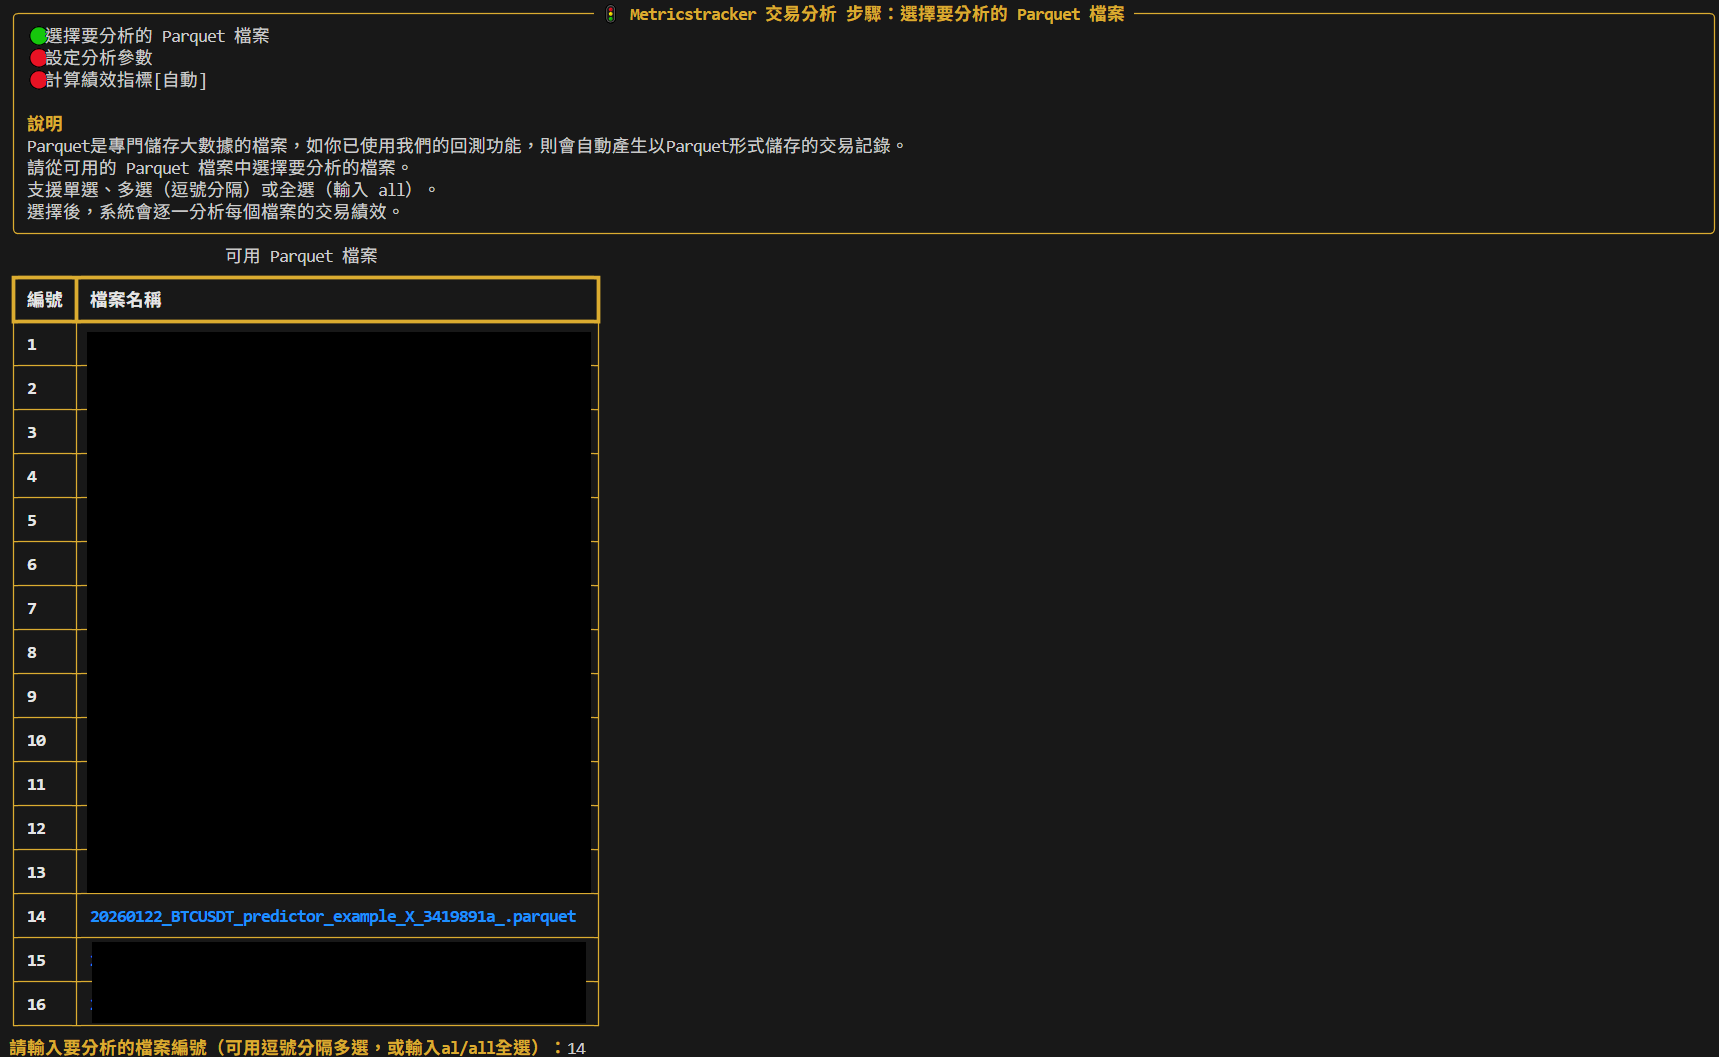
選擇要分析的 Parquet 檔案
現在我們要計算策略表現得怎麼樣。
剛才的所有回測結果,都以一個 Parquet 文件(一個像壓縮了的 Excel 文件,專門儲存大數據 )的形式存放在 lo2cin4bt/records/backtester 資料夾 ,檔案名包含回測日期與唯一識別碼。
系統會列出所有該資料夾的 Parquet 文件,輸入編號並選擇想分析的回測結果檔案。
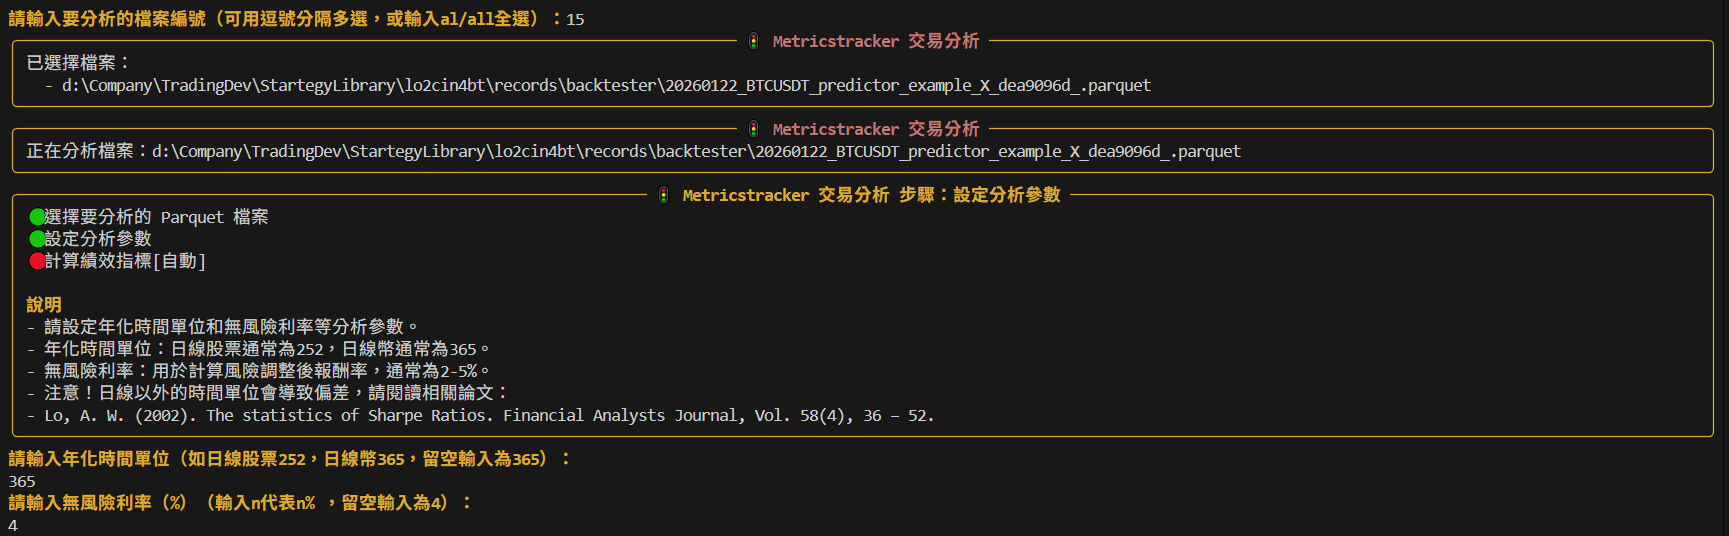
設定分析參數
這一步是給回測成績定個標準。
你需要輸入:
- 年化單位:加密貨幣用 365 (每天交易),股票用 252 (交易日)
- 無風險利率:建議採用預設 4%
這些數字會影響策略成績,比如「夏普比率」的計算方法。
新手建議:
- 留空 Enter 用預設值。
計算績效指標
系統將自動計算績效指標,並將結果存放在 lo2cin4bt/records/metricstracker 資料夾內,這裡也需要等待一段時間。
完成後進入可視化階段。
◉ 進入可視化部份
選擇要載入的檔案
輸入編號並選擇先前生成的 Parquet 檔案。
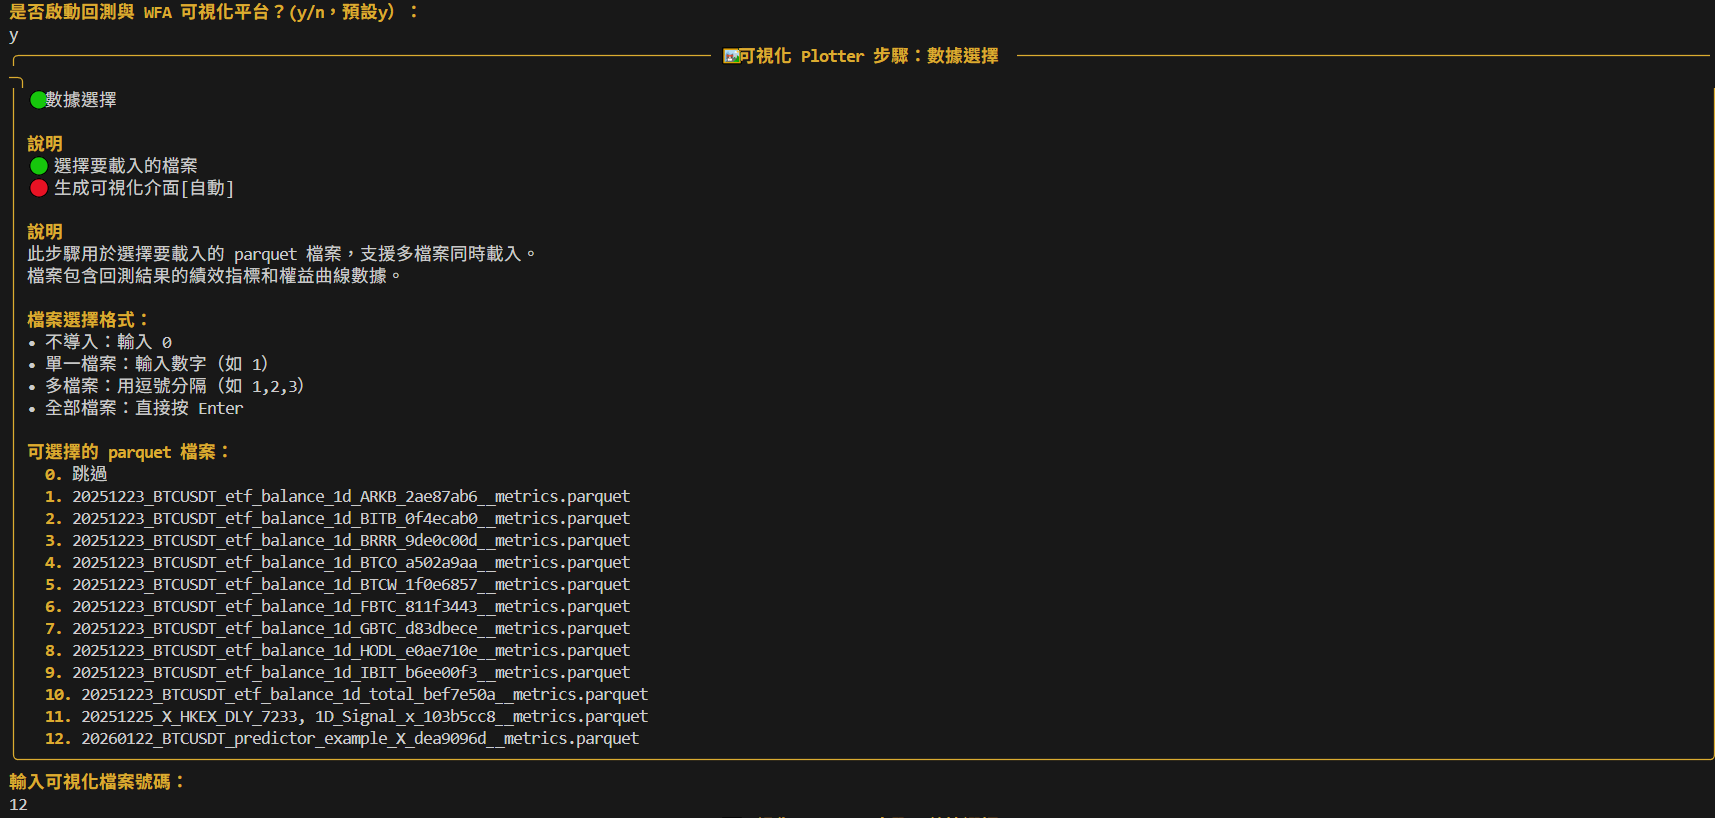
之後系統會要求你選擇 WFA 檔案,這是進階內容,後續再提到,這裡先選擇 0 跳過。
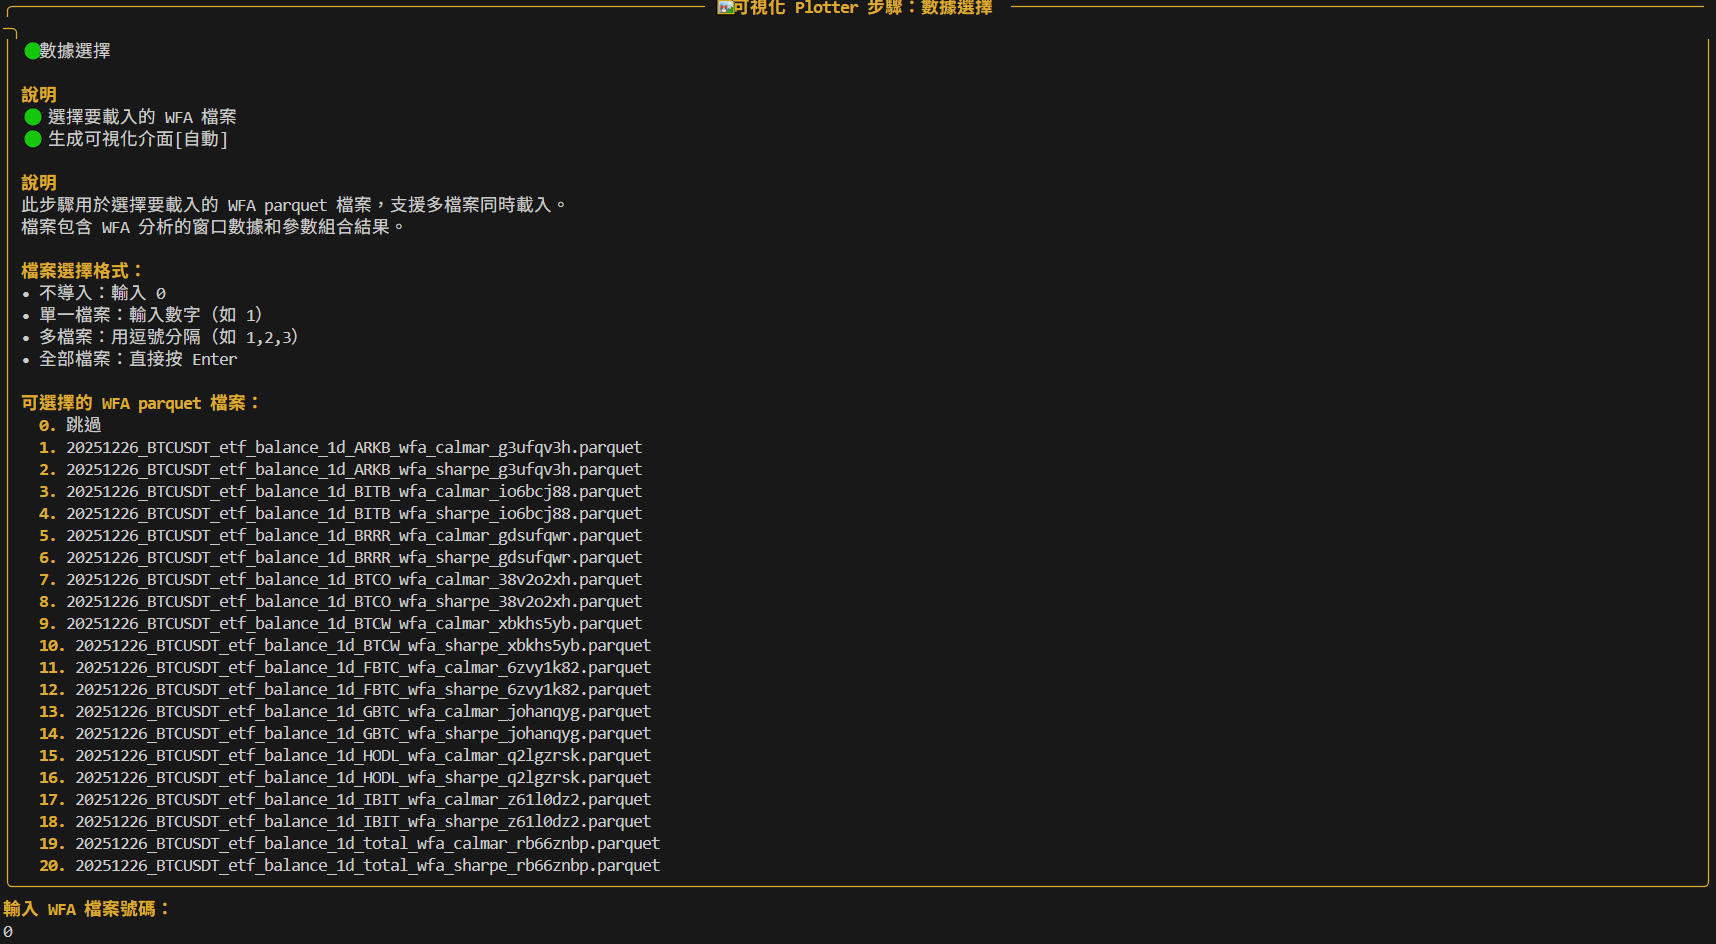
系統將自動運行可視化,分析策略好壞。
資金曲線介面
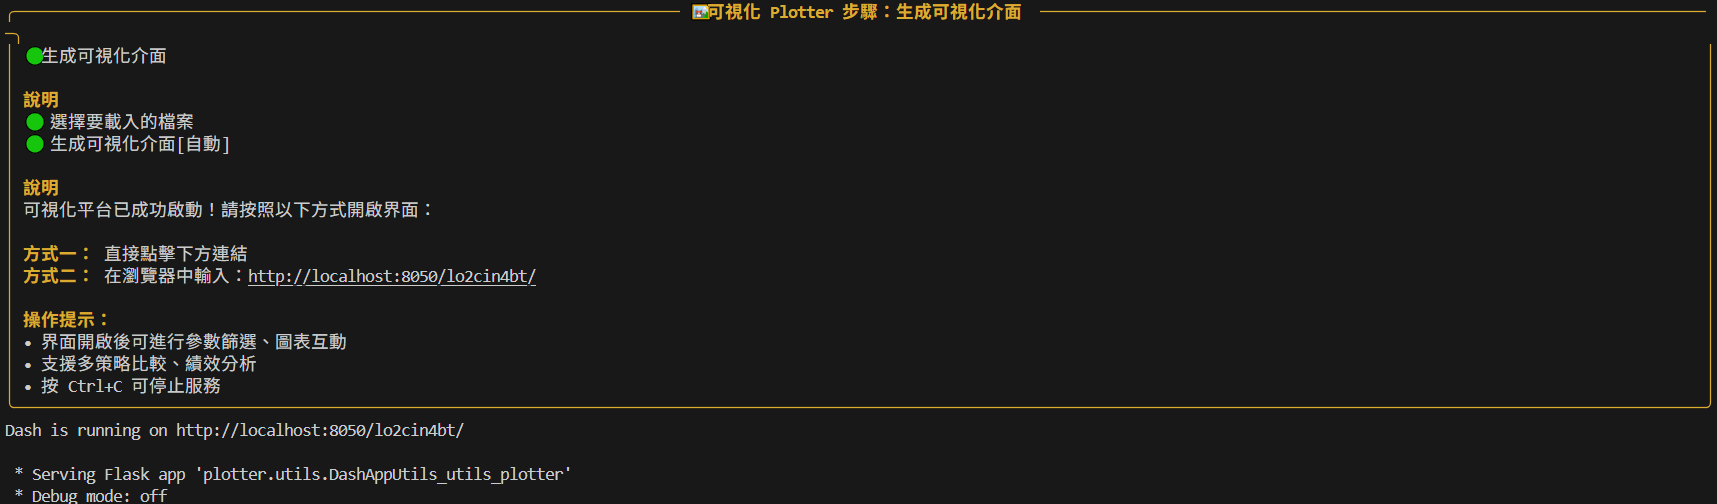
點擊系統給的連結,瀏覽器便會打開一個圖表平台。
最先的畫面是所有策略的資金曲線。
如果試的策略多達幾千個,你可能需要等待數分鐘,才能把曲線圖完全繪製,而且幾千條也很難看得清楚。
所以目前的資金曲線首先會以 TOP 20 Sharpe 顯示。
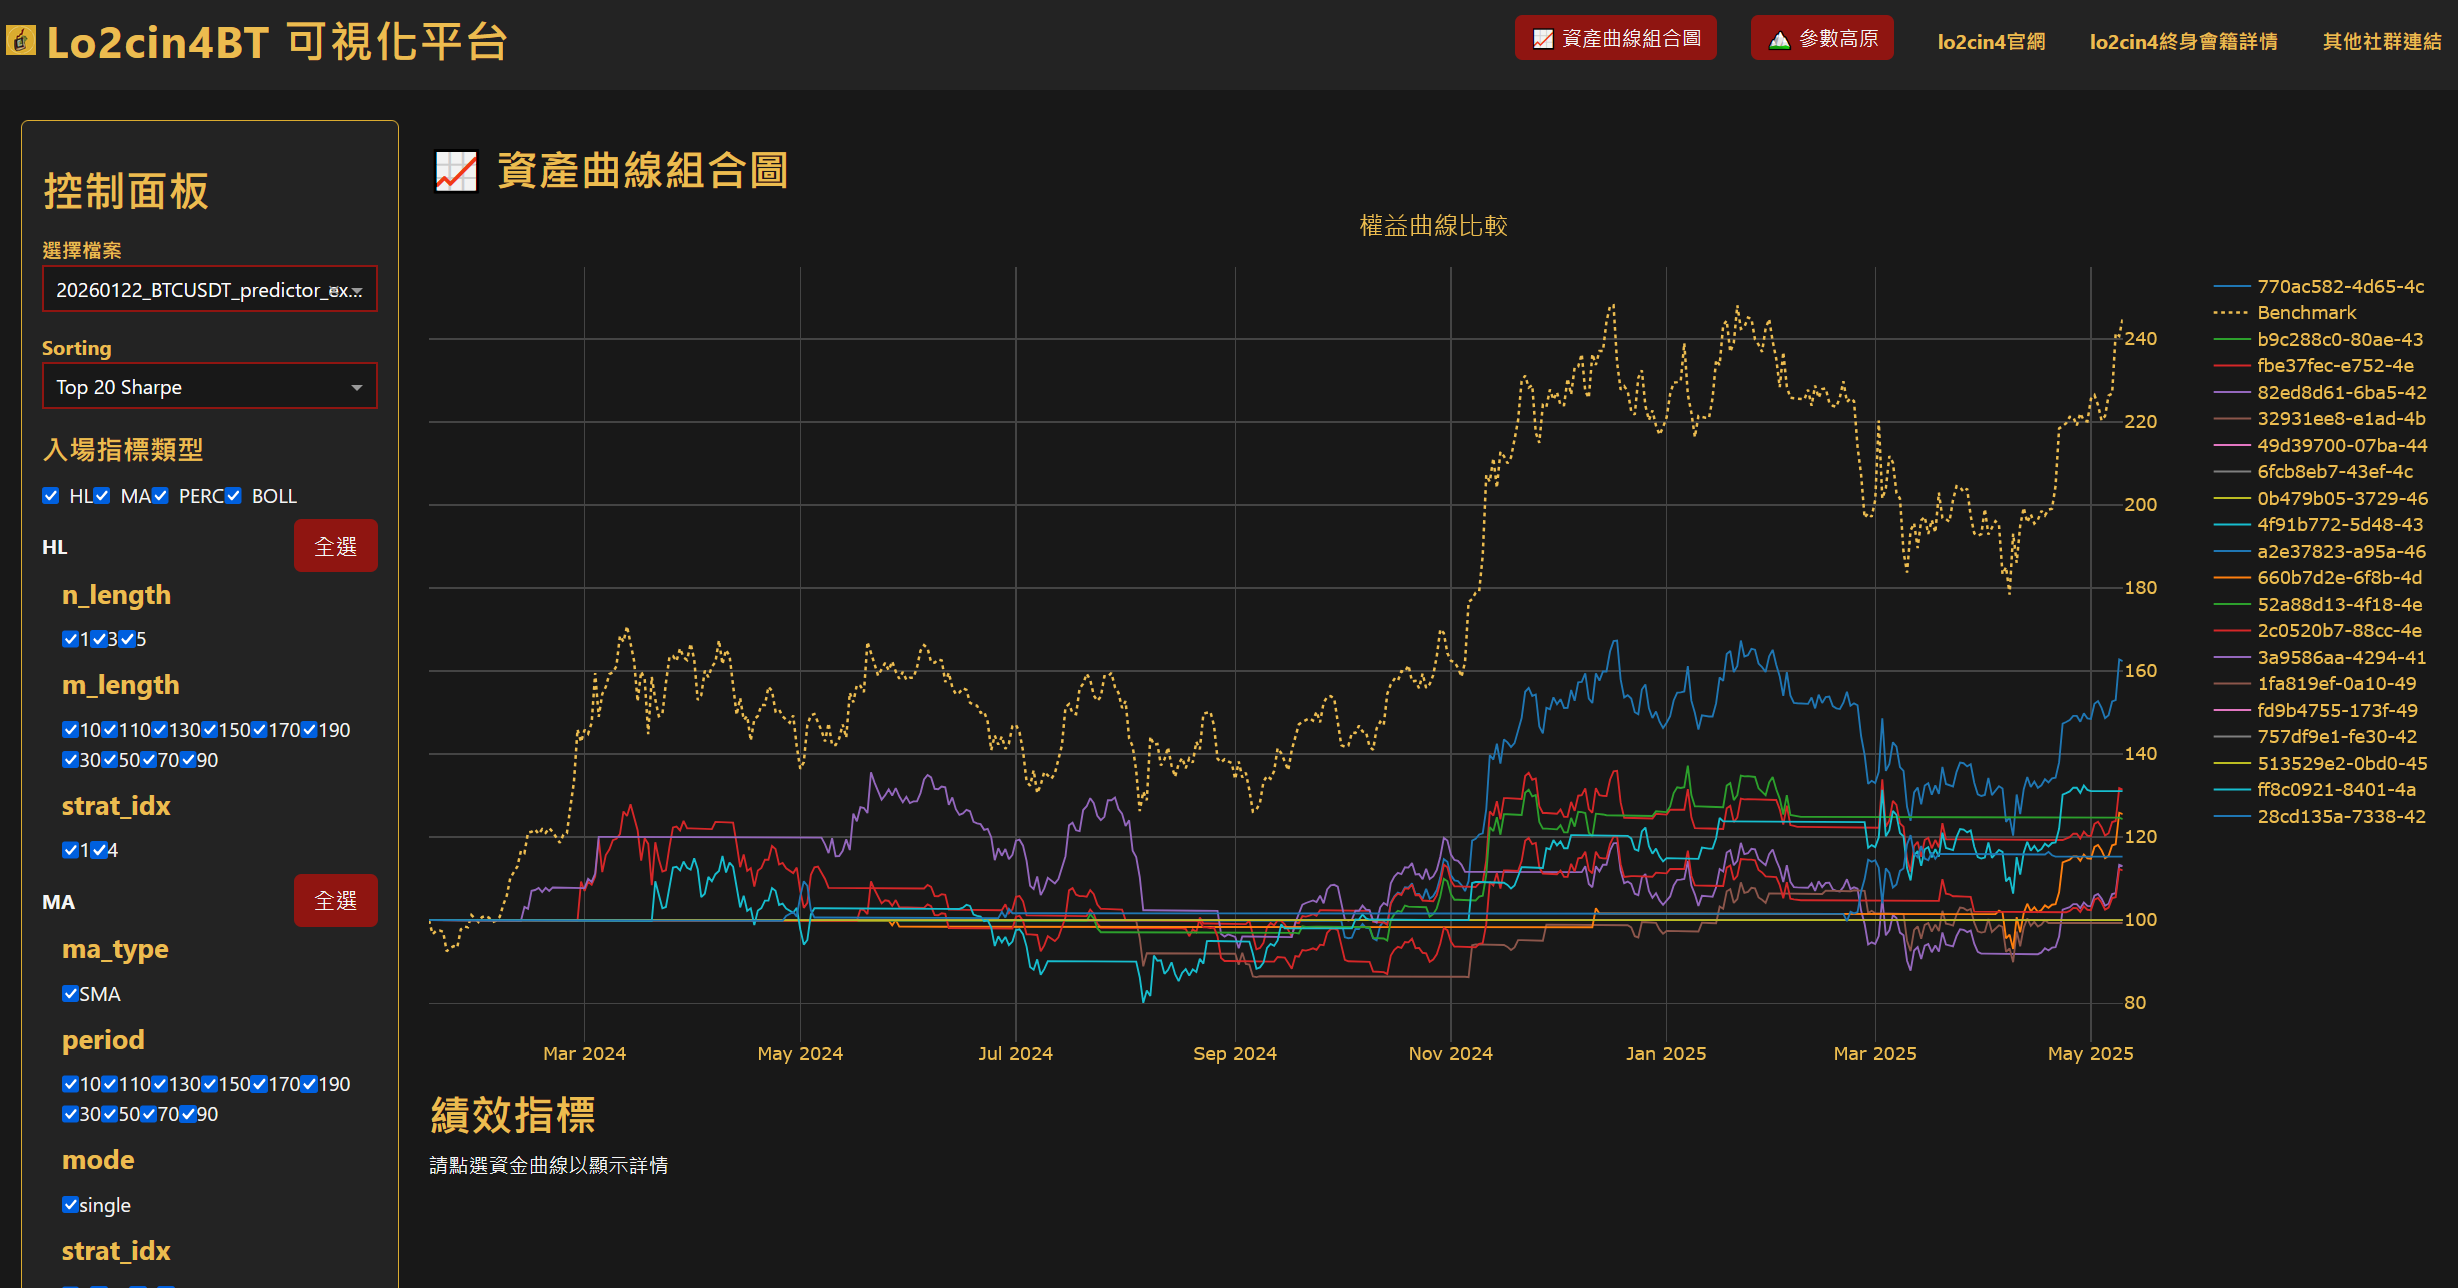
你亦可以在左側控制板,選擇只顯示哪些入場或出場條件的策略,或者選擇 All Results 顯示所有。
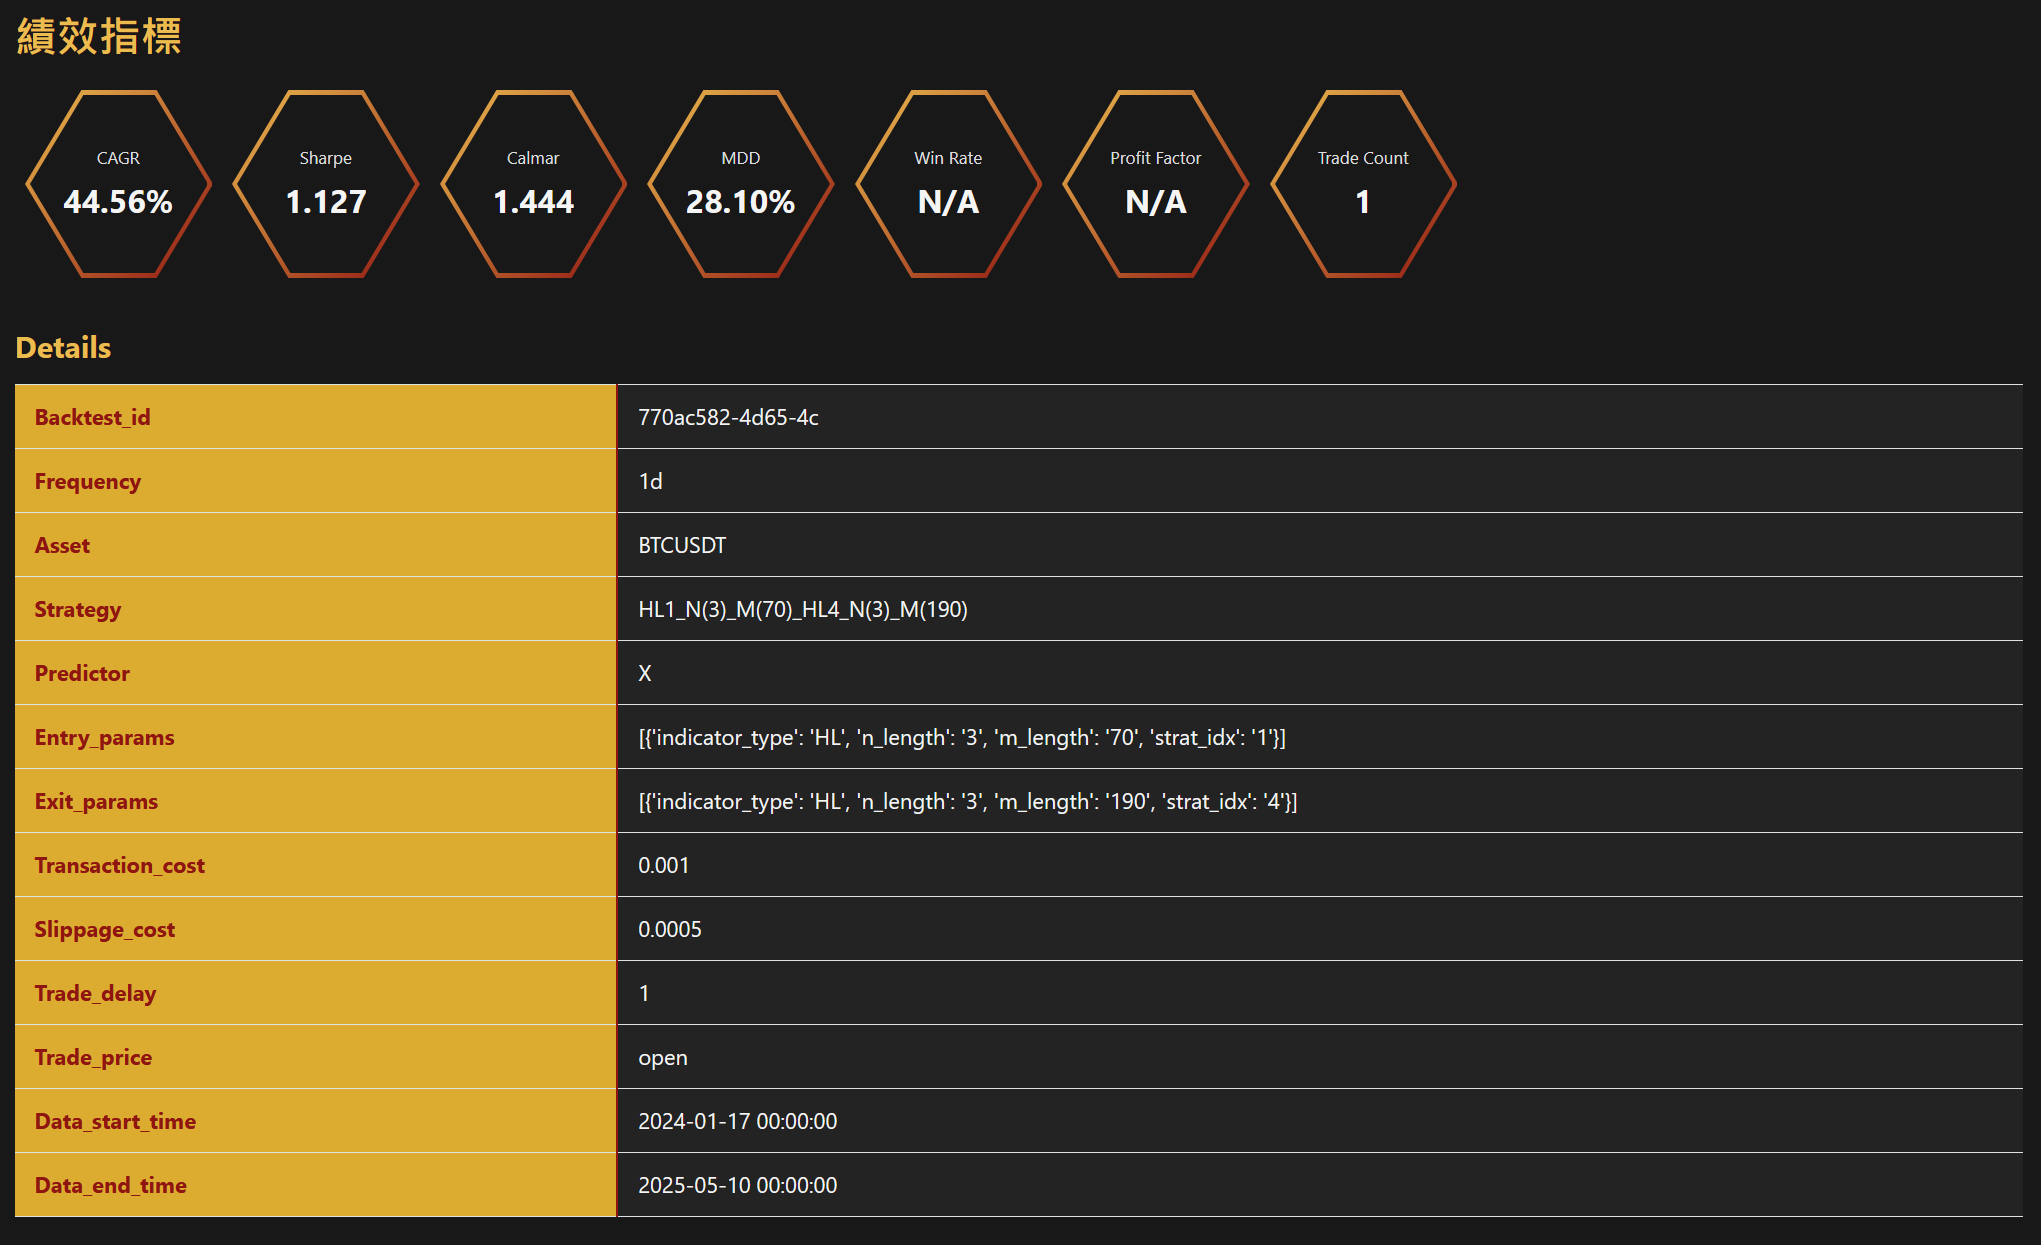
而在圖中點擊任何一條曲線,便能看到該單一策略的詳細成績,如下圖。
參數高原介面
在頂部點擊「參數高原」,便可以顯示各策略的表現二維圖。
在下拉欄選擇檔案與策略後,便可以觀察同一策略、不同參數下的夏普比率( Sharpe )、索丁諾比率( Sortino )、卡瑪比率( Calmar )及最大回撤( MDD )等指標的表現。
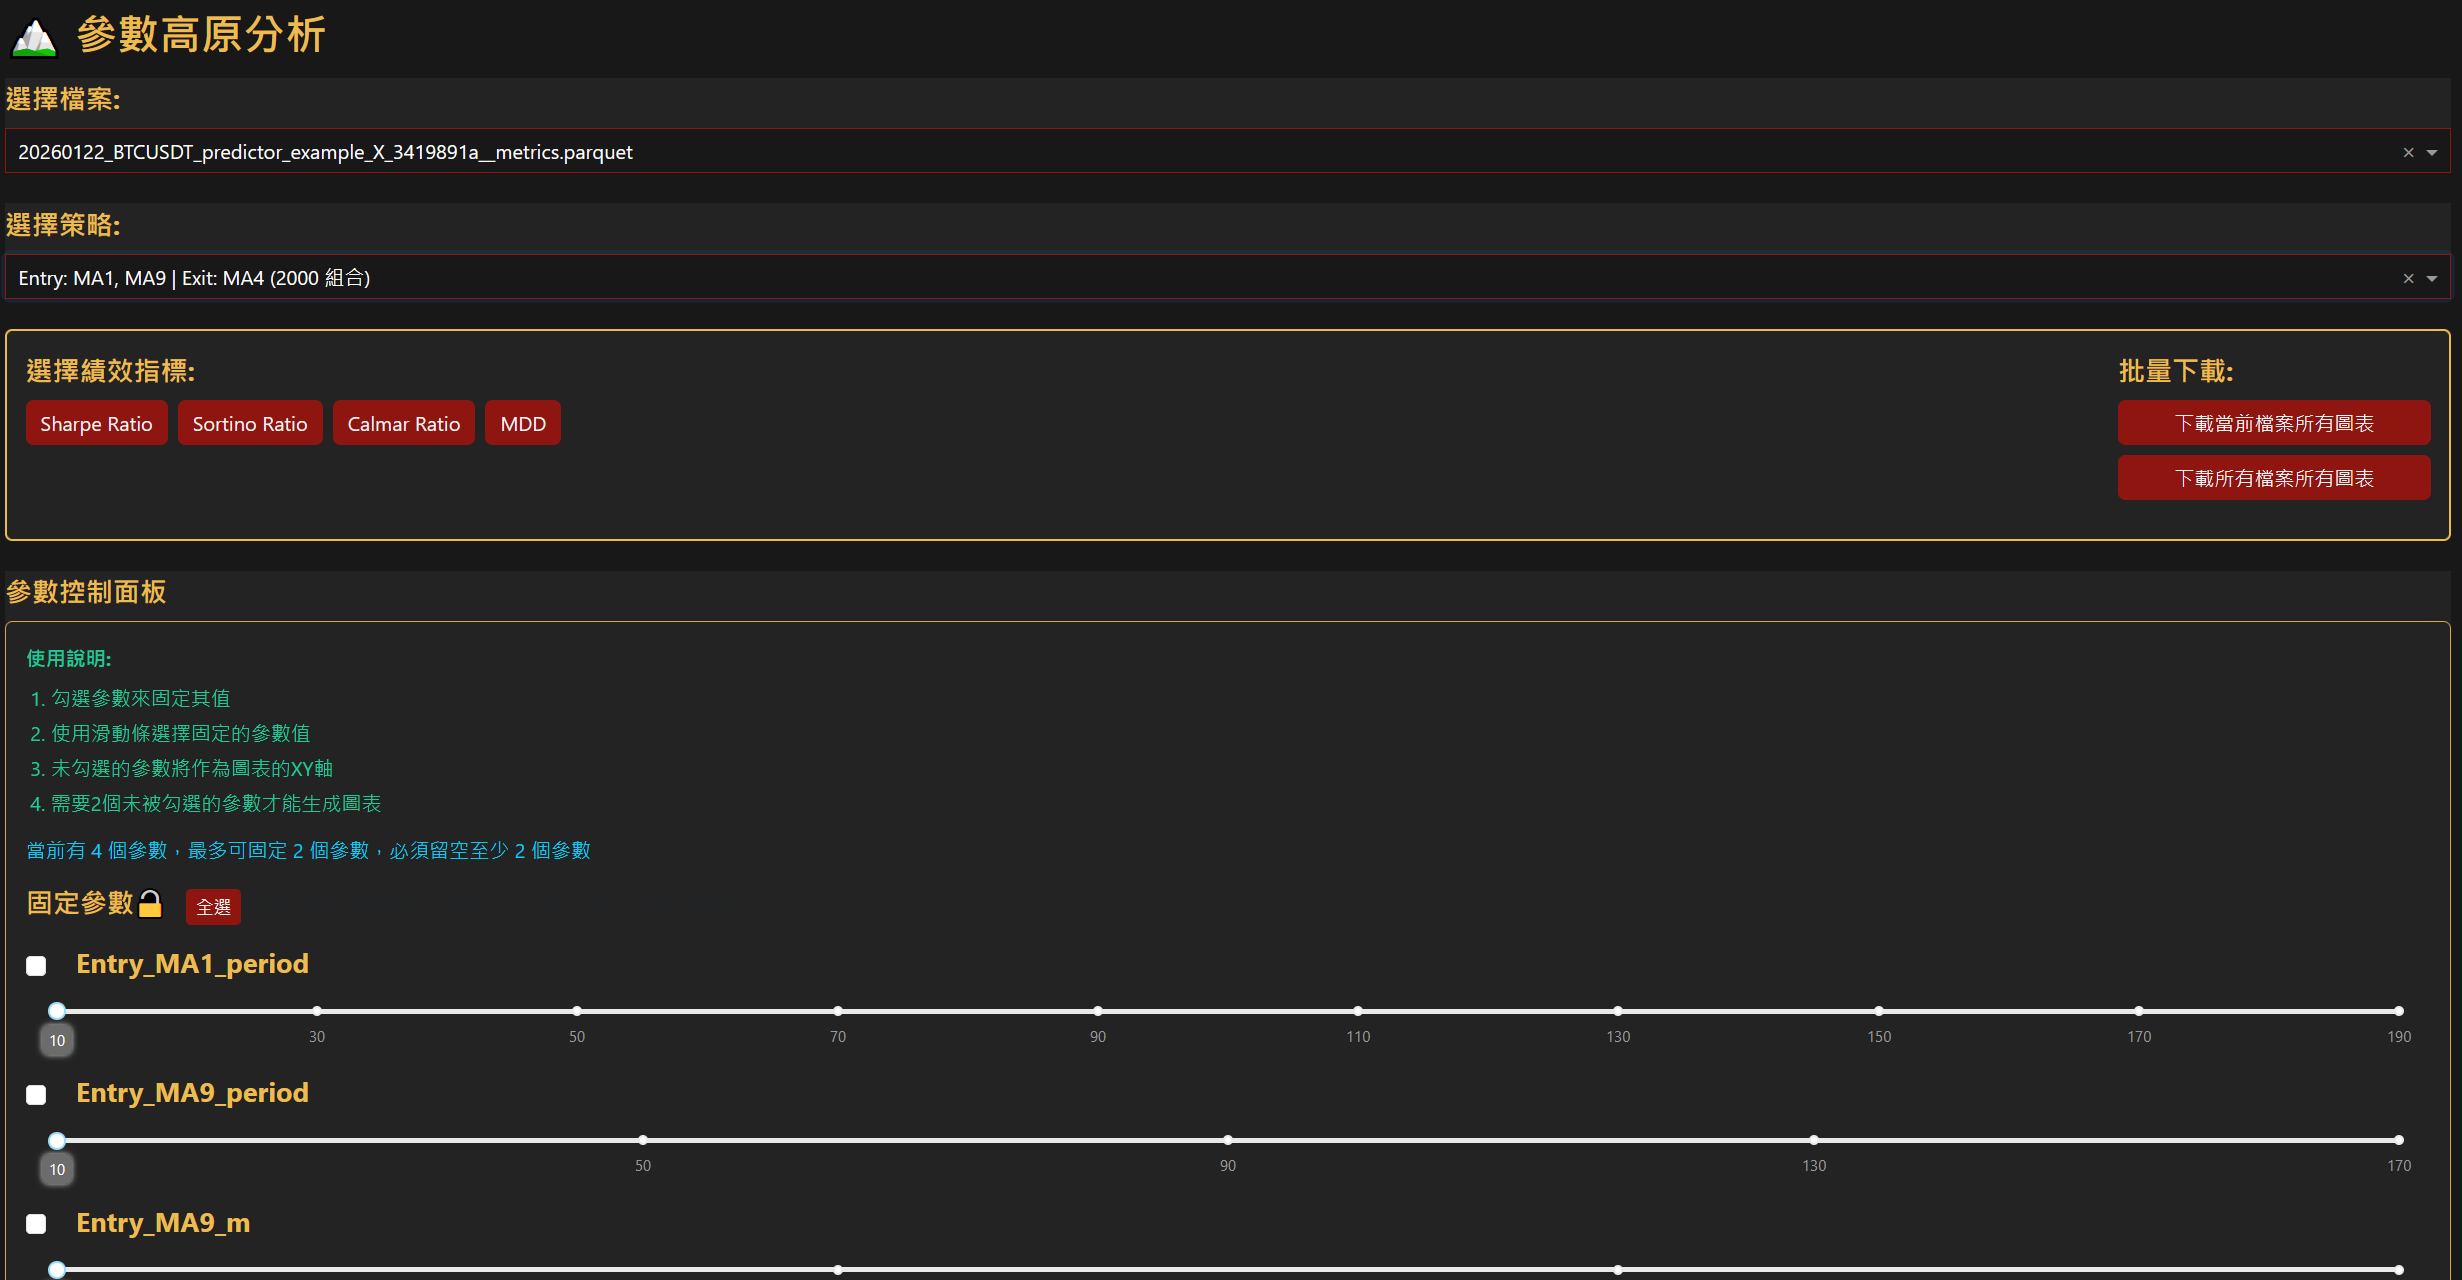
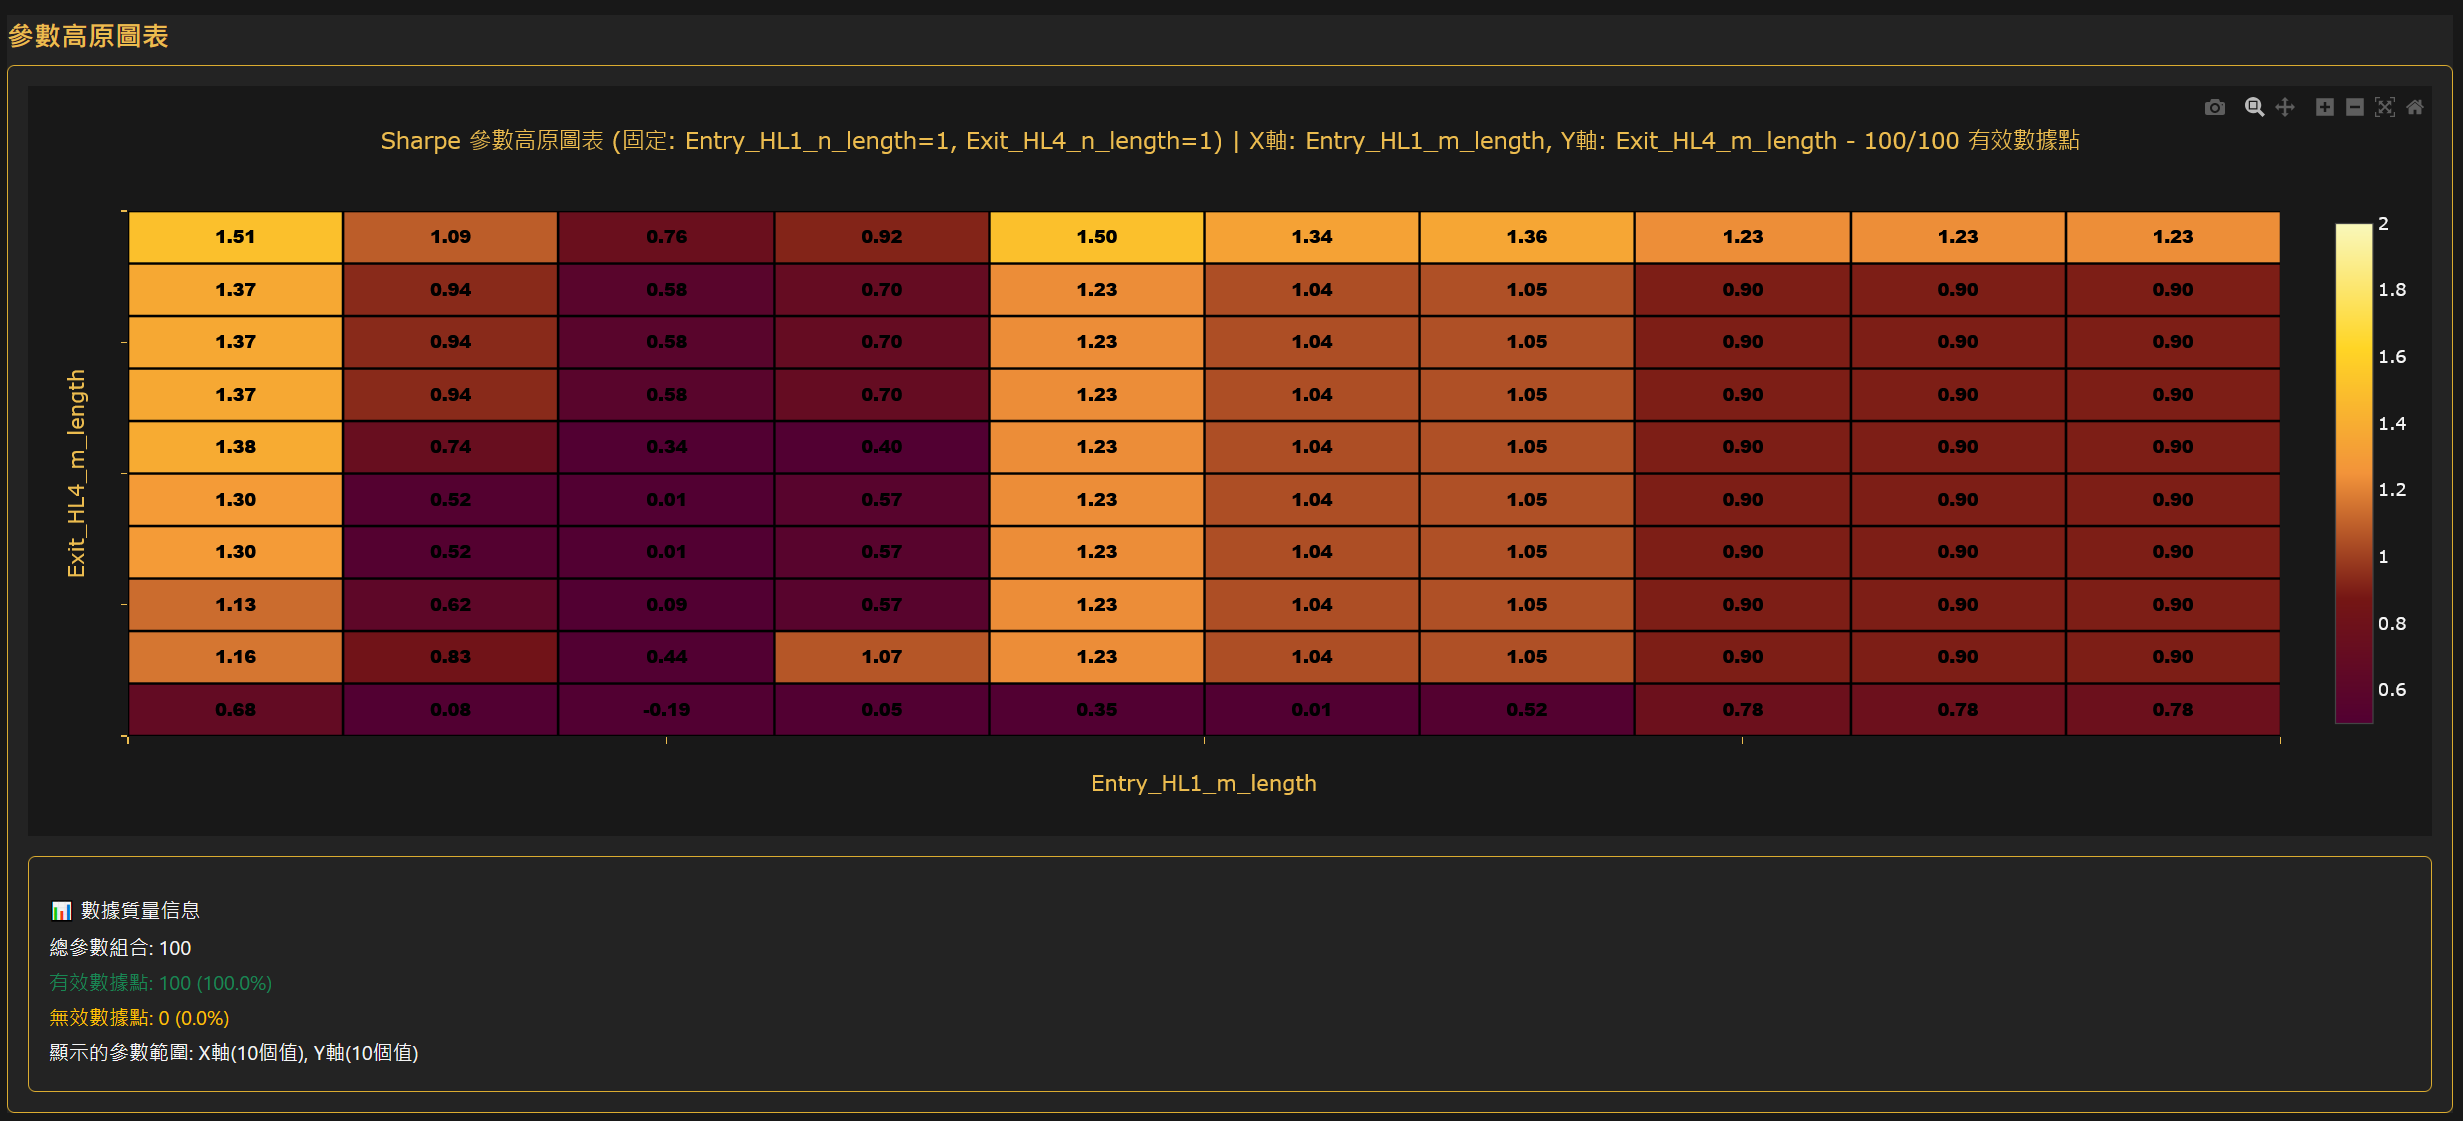
由於為二維顯示,只能展示兩個參數的交叉變化。
若策略包含多個參數,可在參數控制面板鎖定部分參數並指定數值。
例如,選擇 HL 策略(連續 N 日突破 M 日前高點買入,連續 N 日跌破 M 日前低點平倉),鎖定開倉和平倉參數 N 同為 3 ,便可觀察不同 M 值下的策略表現。
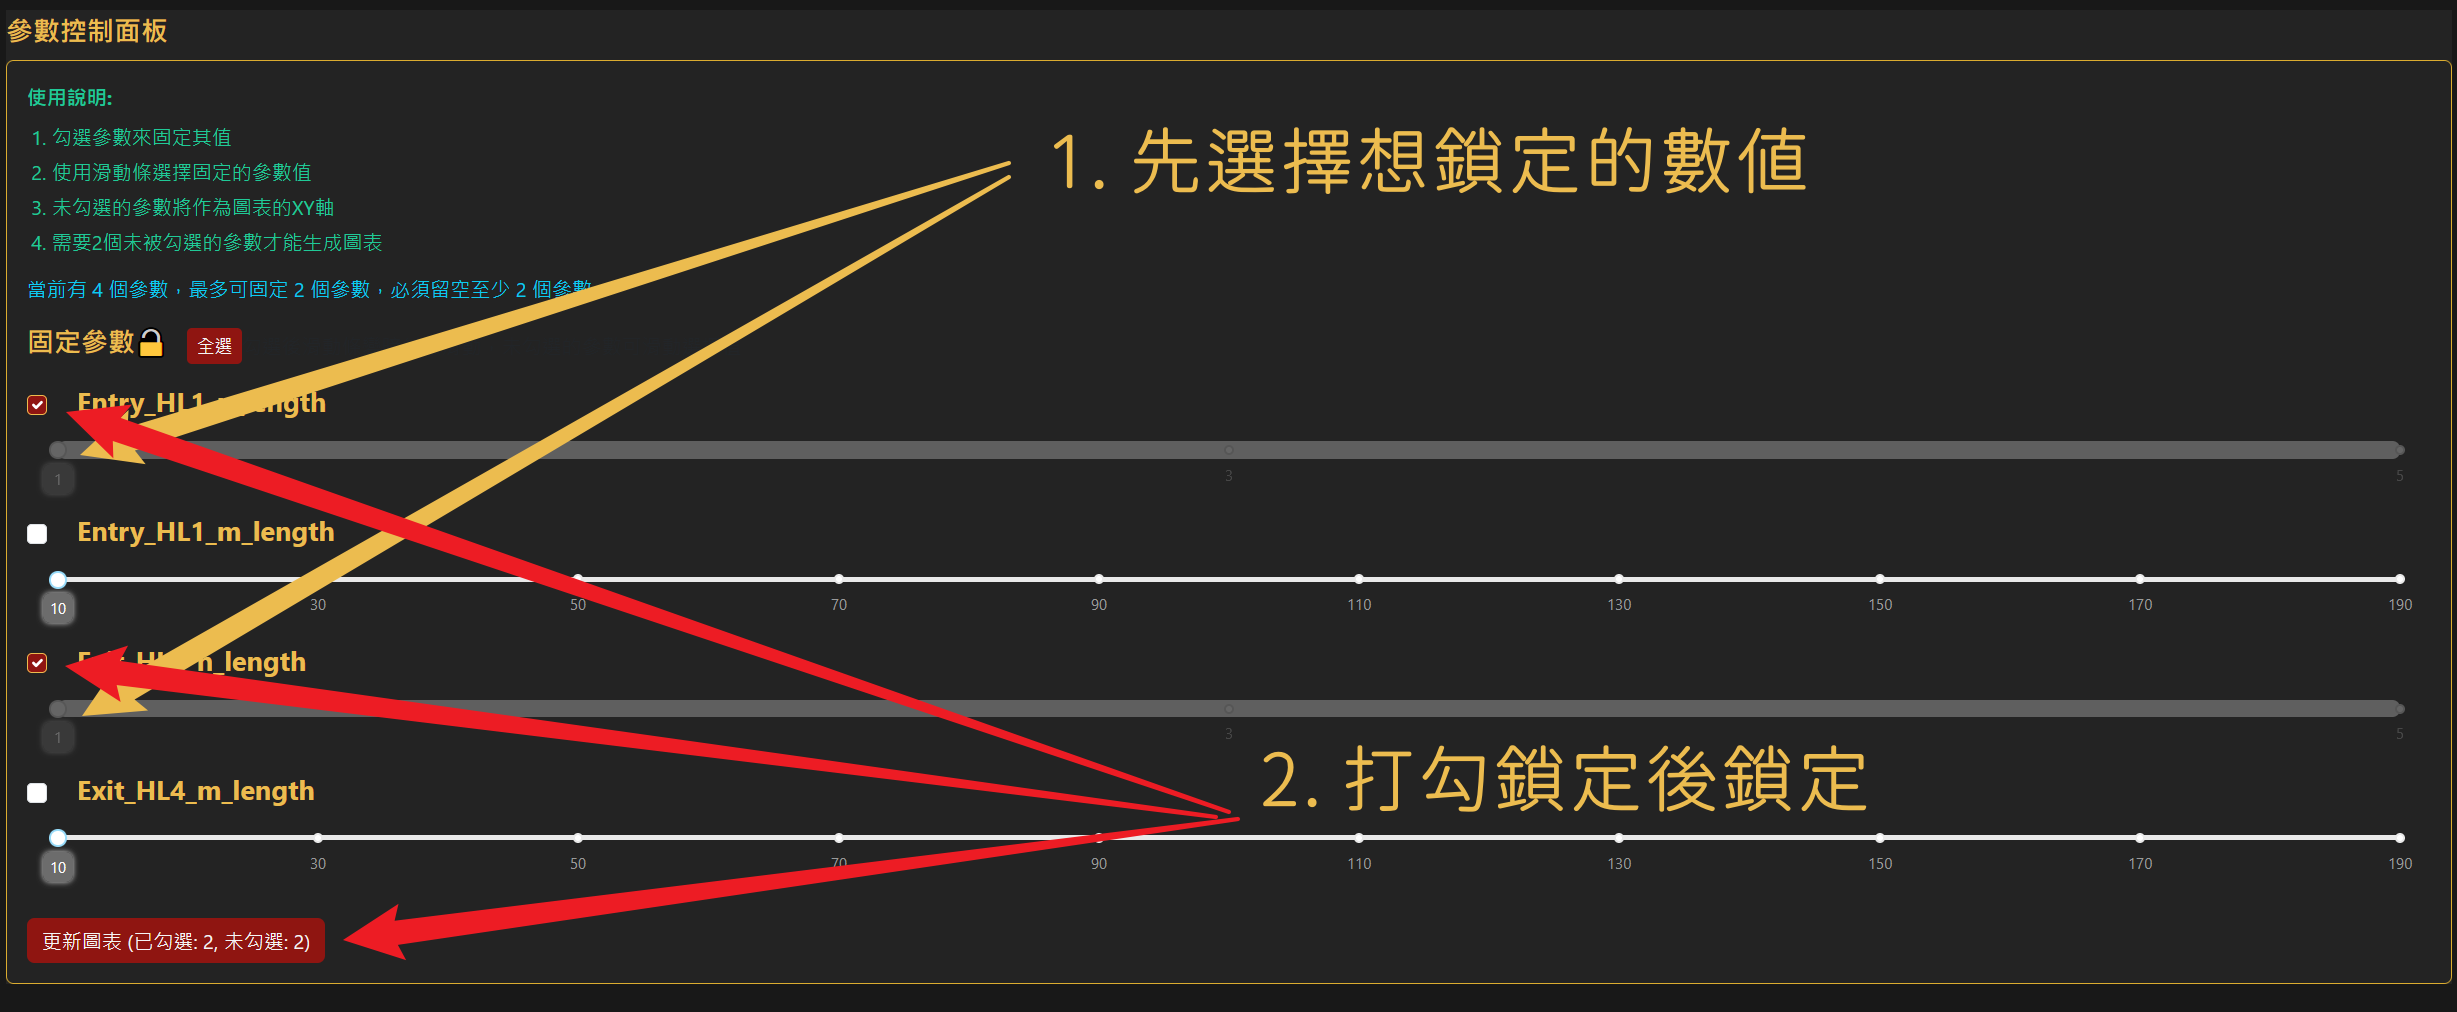
「參數高原」的用途是檢測過擬合。
理想的「參數高原」應顯示連續範圍內的穩定高表現(光亮格子聚團),而非孤立的高表現點(孤島)。
後者代表參數只需輕輕微調,便會導致績效大幅下降,該參數只是湊巧踩中行情、過擬合的可能性便會大增。
◉ 策略判斷標準
你已經跑完一次量化交易模擬!
如何初步判斷策略是否優秀?
我有以下標準:
參數高原,九宮格內最好至少有 7 個回測結果符合以下數值:
- Sharpe Ratio > 1
- Calmar Ratio > 1
- Sortino Ratio > 1
之後再進入後續的前向分析 ( WFA ) 檢驗。
如果你覺得手動一個個看比較麻煩,你也可以點擊該介面那兩個批量下載按鈕,將所有參數高原以圖片方式下載到 records/plotter 內,一次對比更加方便。
◉ 進階操作– Autorunner 配置文件回測
當你已經熟習了回測流程後,便可以省略以上不斷輸入的過程,改為在 lo2cin4bt/records/autorunner/backtester_autorunner / 下建立 json 檔案,並選擇主選單的自動化回測 Autorunner。
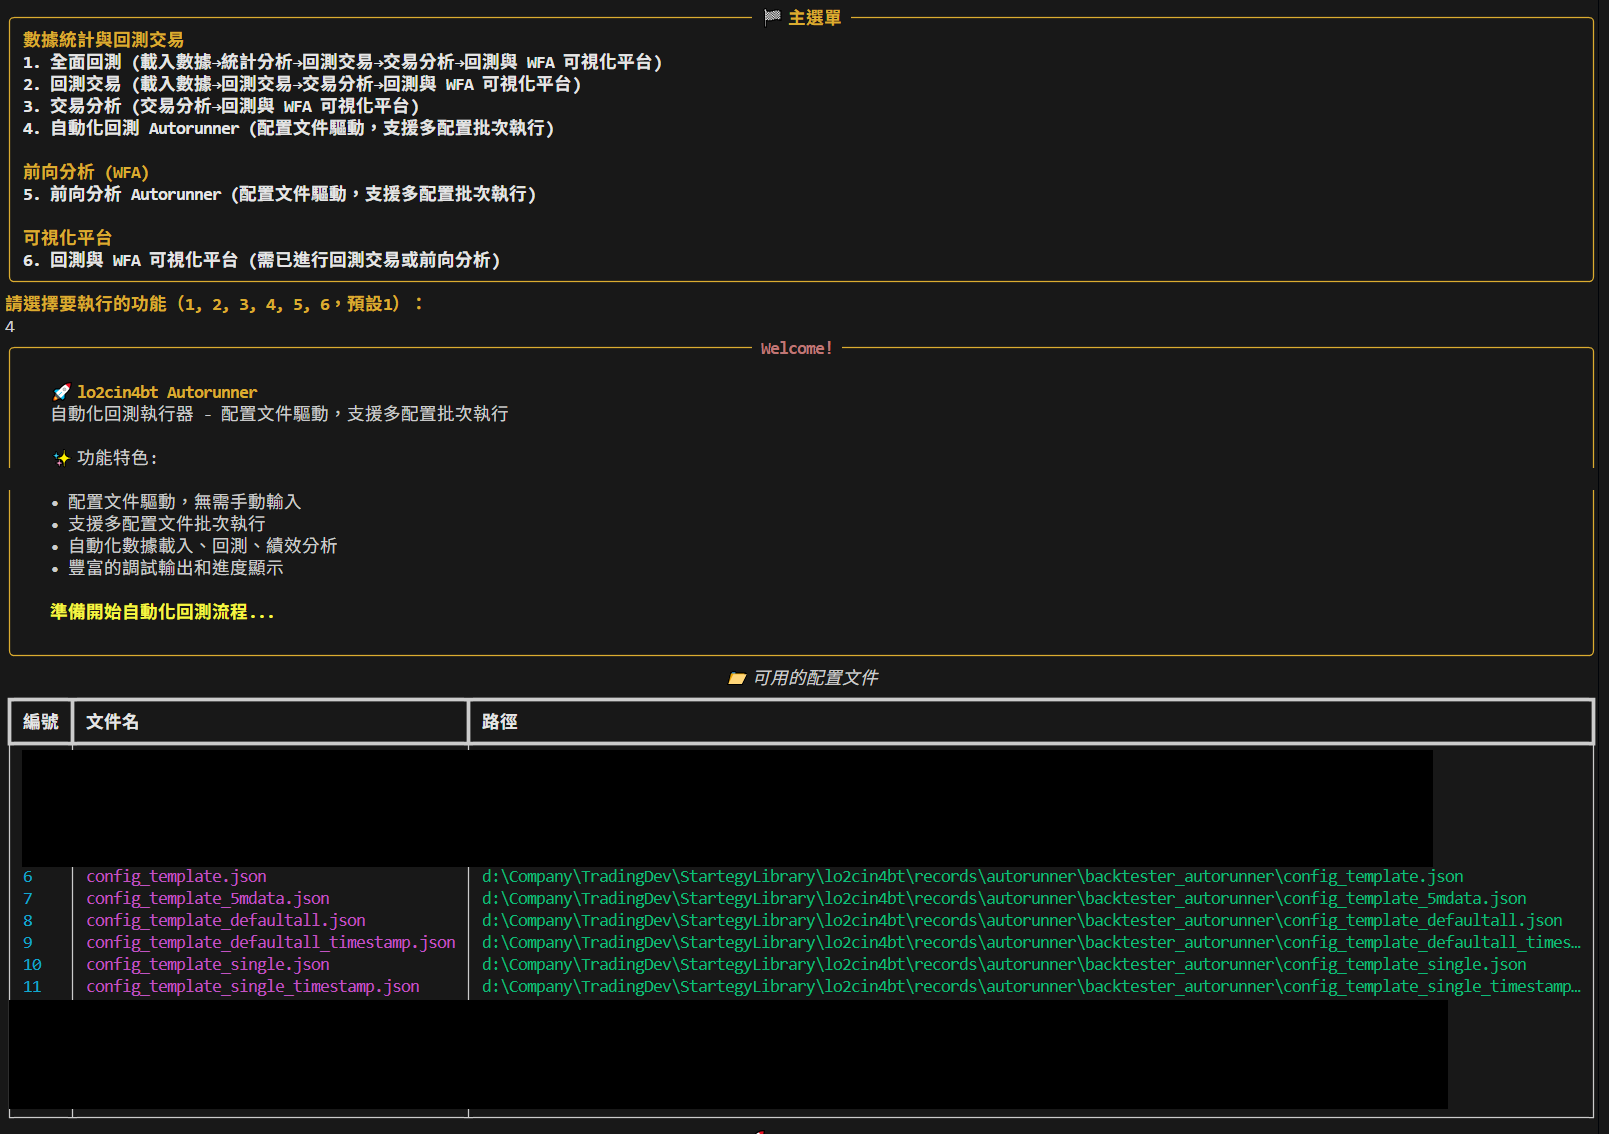
我已提供了多個範本供 AI 參考,屆時可以讓 AI 參考並建立回測配置。
舉個例子,你可以叫 AI:「參考 records\autorunner/backtester_autorunner / 內的 config_template_defaultall.json,預測文件改為使用 records\dataloader\import 的 YYY 文件,時間改為 2022 年 1 月 1 日至 2026 年 1 月 1 日,建立一份新的 json 文件」。
運行後系統會自動檢查文件是否符合要求,之後再回測。
◉ 前行分析 ( Walk forward analysis, WFA )
上面提到的參數高原分析,雖然能幫助我們識別參數的穩健性,但它仍然是在同一份歷史數據上進行優化,無法完全消除過擬合問題。
就像是在考試前背熟所有題目答案,雖然在練習時表現完美,但遇到新題目(未來的市場數據)時可能表現不佳。
WFA 通過將數據分為訓練集(IS)和測試集(OOS),在訓練集上優化參數,然後在獨立的測試集上驗證,就像真正的考試一樣,能夠更真實地評估策略在未來市場中的表現。
- WFA 可以做什麼?
- 將歷史數據劃分為多個時間窗口,每個窗口包含訓練集和測試集
- 在每個窗口的訓練集上優化策略參數(尋找最佳 Sharpe、Calmar 等指標)
- 在對應的測試集上驗證優化後的參數表現
- 通過多個窗口的 IS/OOS 對比,評估策略的穩健性和泛化能力
- 識別策略是否在訓練集上表現良好,但在測試集上表現不佳(過擬合警告)
- 兩種 WFA 模式:
- 滾動模式(Standard):固定訓練集和測試集大小,每次向前滾動固定步長,適合評估策略在不同時間段的穩定性
- 錨定起點模式(Anchored):固定起點,訓練集逐步增長,測試集大小固定,適合評估隨著歷史數據增加,策略表現如何變化
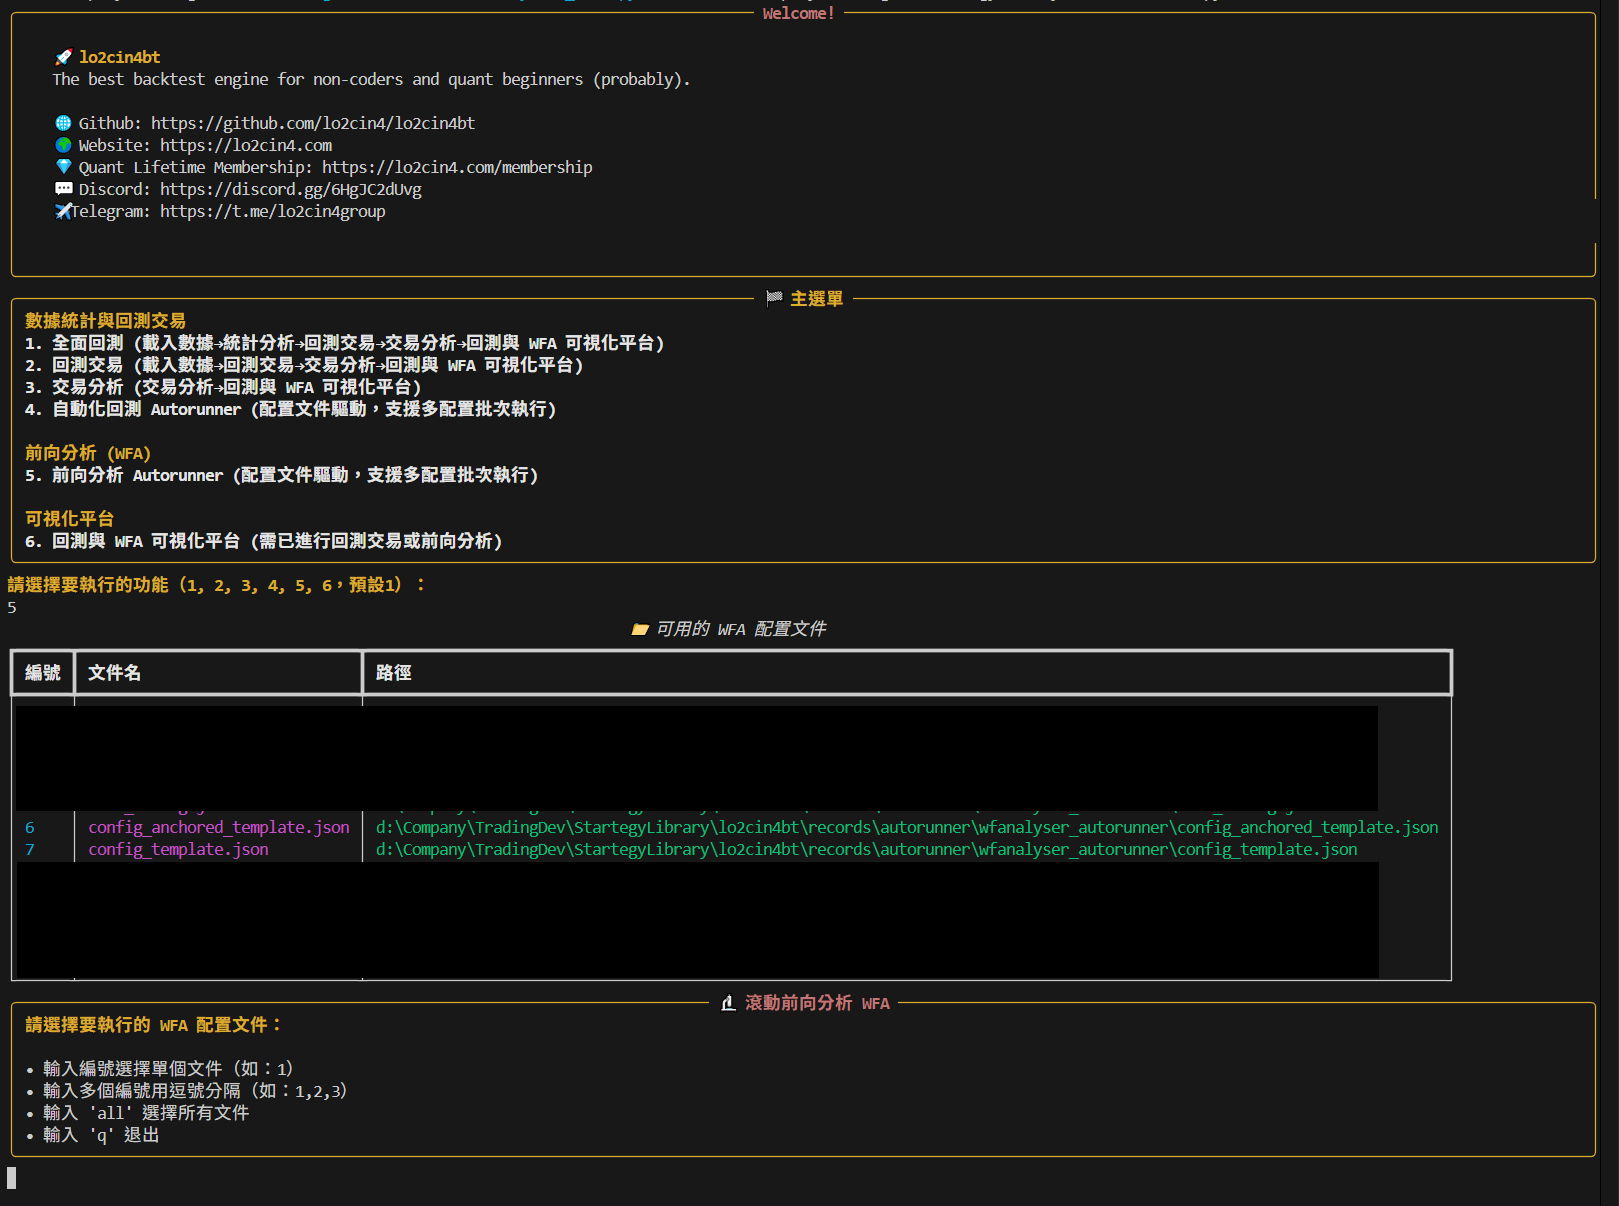
配置方式:目前僅提供配置文件模式,在 records/autorunner/wfanalyser_autorunner/ 中設定 WFA 配置文件即可執行。
詳細配置範例請參考 records/autorunner/wfanalyser_autorunner/config_template.json 和 config_anchored_template.json
在主選單選擇 5 ,再選擇對應的檔案,系統便會自動運行前向分析。
前行分析的細節與詳細設置將會在未來會員文章講解。
◉ WFA 可視化平台
當你做完前向分析後,可以回到主選單並啟動可視化平台,並選擇這次的分析檔案,之後便可以看到置頂多了一個前向分析 (WFA) 按鈕。
點擊後會進入以下介面,同樣可以選擇檔案和策略。
再下面則是按照定義的不同時間窗口所做的回測結果分析。
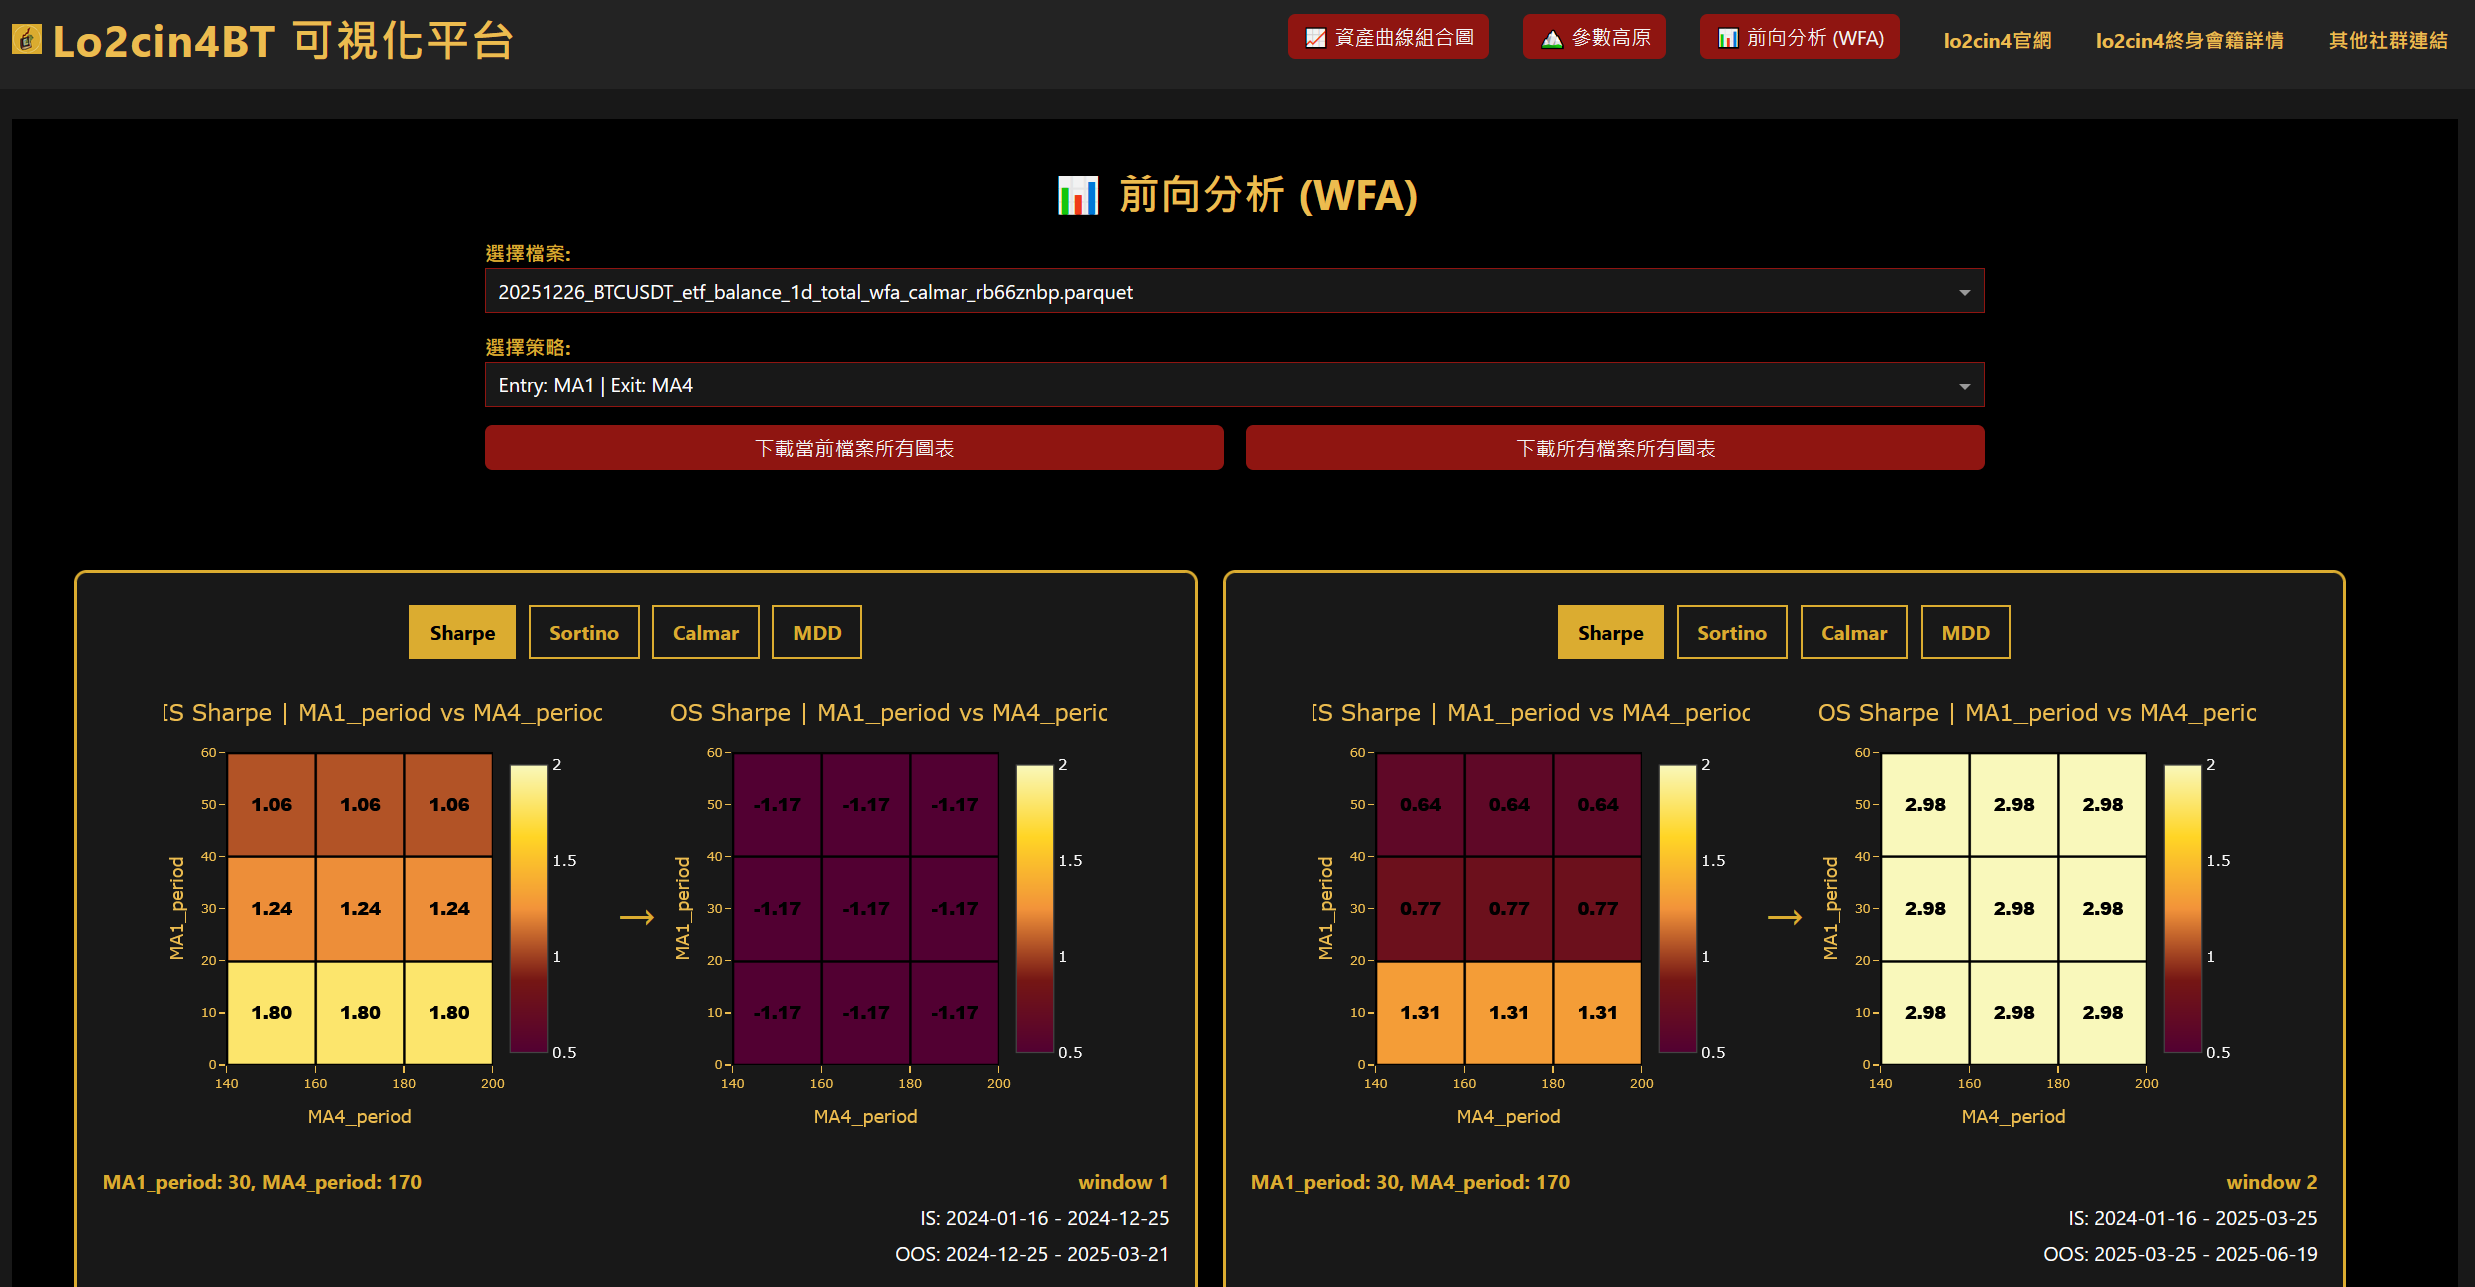
每個窗口的左面就是使用訓練集得出的最優解九宮格,而右面則是該九宮格的參數在測試集的表現。
以第一個為例,2024 年 1 月 16 日至 2024 年 12 月 25 日這段時間裡,MA1 的參數選 0 ~ 60、MA 4 的參數選 140 ~ 200 的表現最佳。
但這堆參數去到 2024 年 12 月 25 日至 2025 年 3 月 21 日的夏普率則完全不行。
我們其中一個準則,就是希望看到策略在訓練集和測試集表現相差不大。
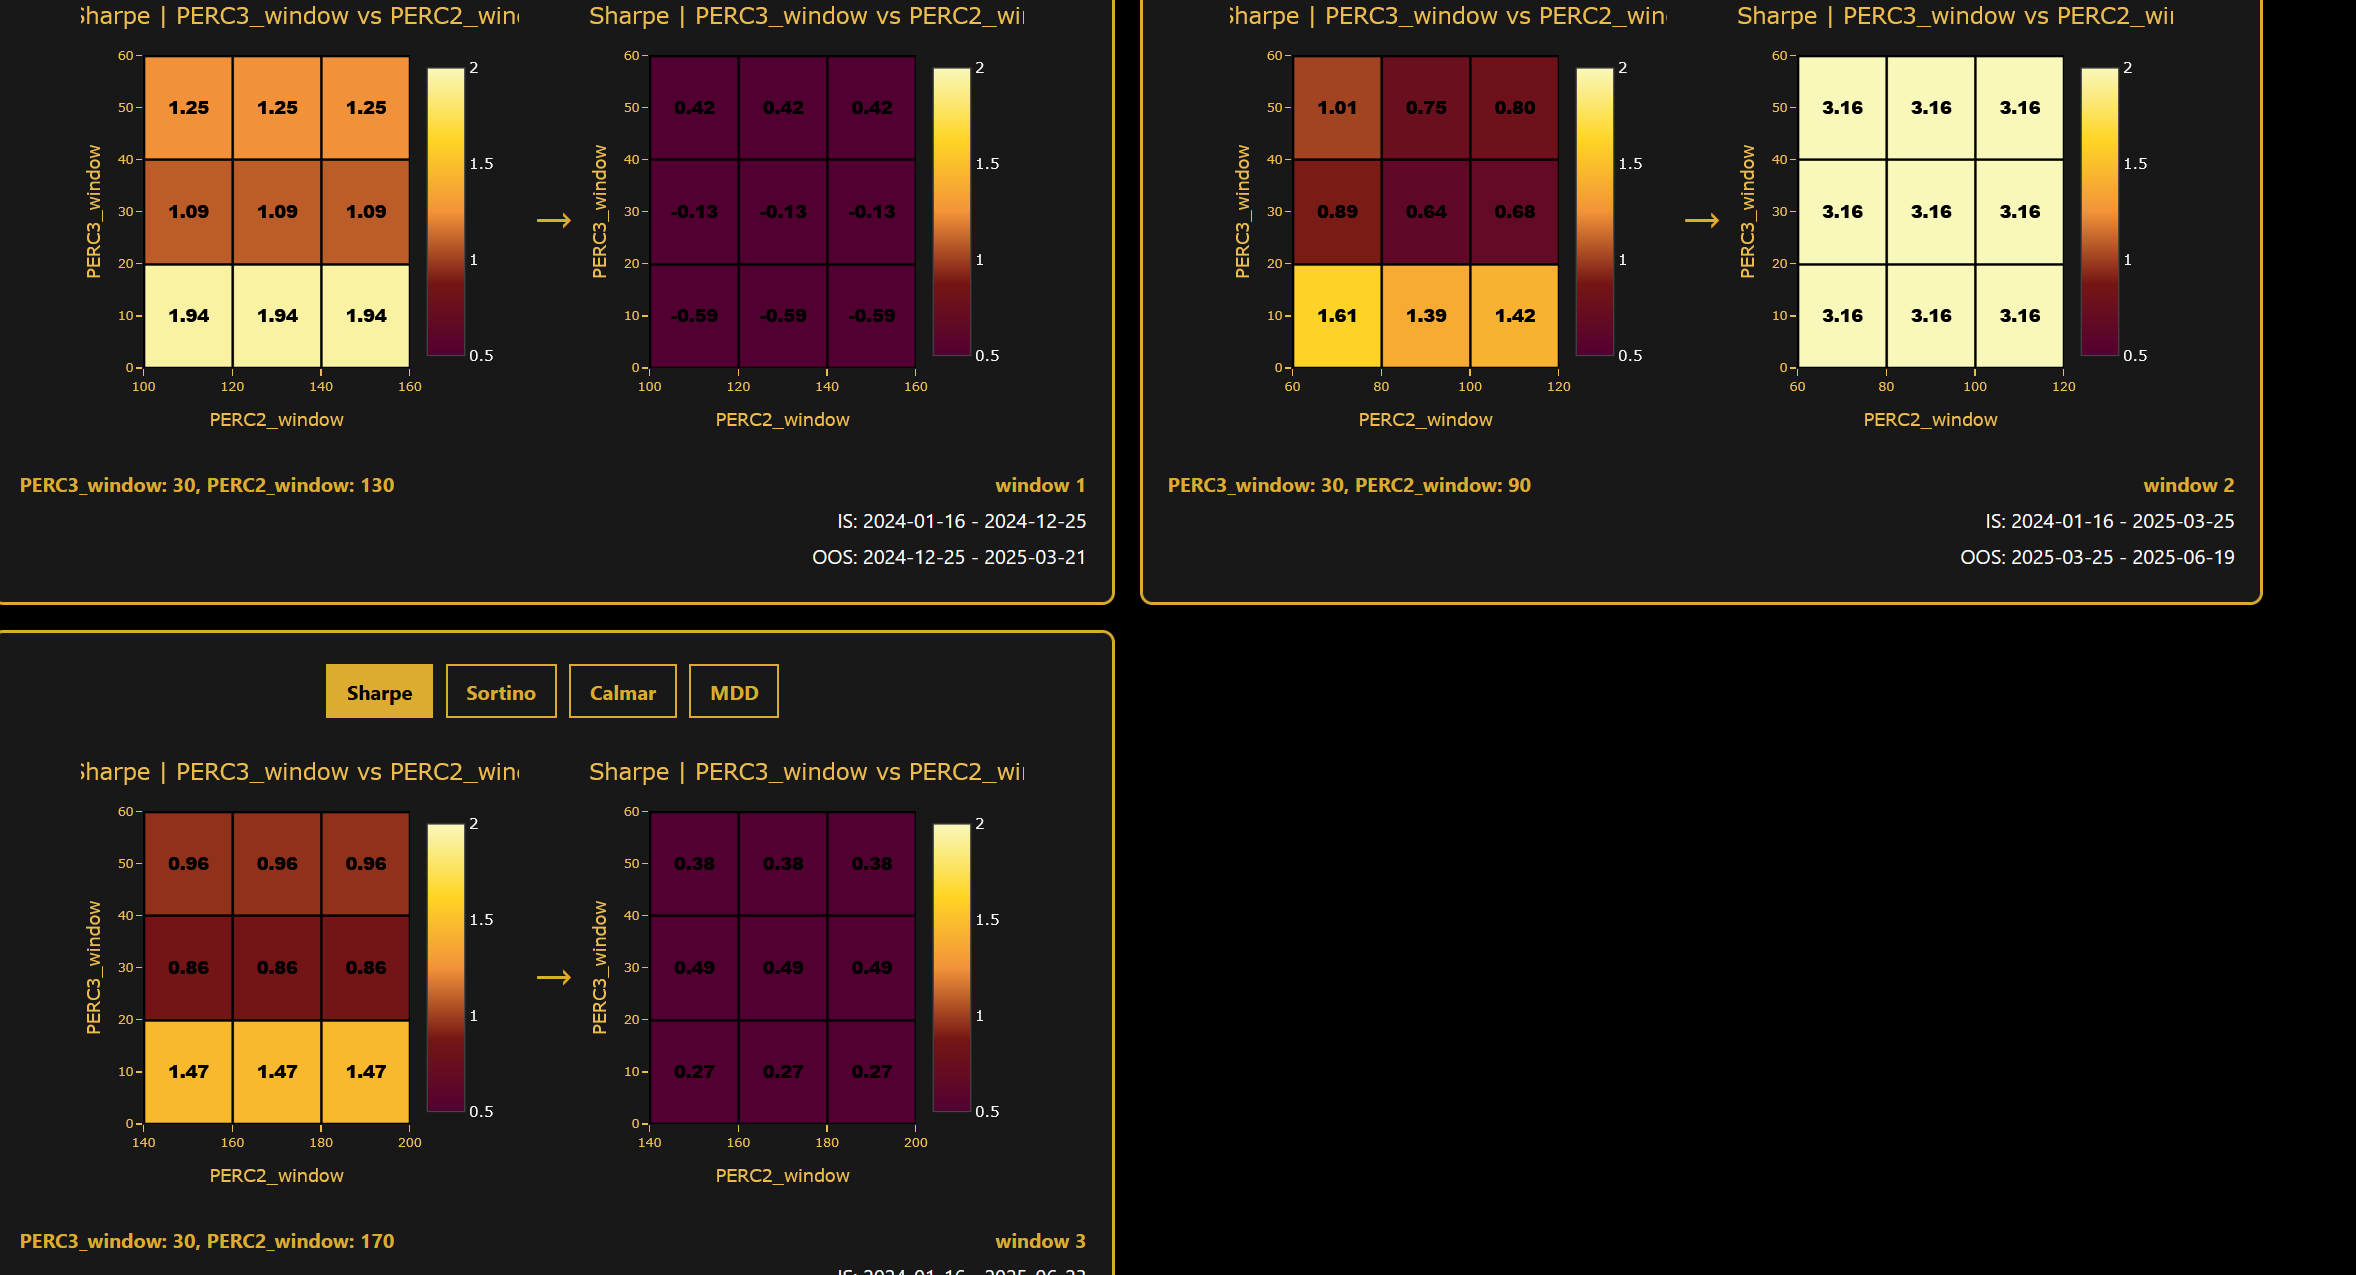
另外一個重點則是看每個訓練集的參數是否相近。
如相近,代表策略在不同時間都展現出穩定性;
反之則代表時間對於參數的影響極大。
在下面這反面例子,PERC2 的參數從 100 ~ 160,變到 60 ~ 120,最後再變到 140~ 200,就是個很不穩定的參數。
◉ 找到好策略之後
如果你已找到能通過以上所有要求的策略,接下來,便可以按以下檢查清單,再次審視你的策略:
- 截圖記錄
首先將資金曲線與參數高原圖表截圖記錄,以待後續討論。 - 測試其他參數
除了少數策略,其他策略通常都不只兩個參數。
滑動固定參數的數值,看看在固定參數變化後,參數高原有沒有明顯變化。 - 邏輯對不對
能解釋的策略比回測更加重要。
比如, MVRV 突破均線時,代表甚麼意思?
為何它能具備預測能力? - 是否已避免未來函數問題
加密貨幣市場 24 小時交易,昨日開盤和今日開盤的數據可能只差 1 秒。
確認你的數據能及時獲取甚至提前預測,要不然就只能再測試延遲一天後的收市價表現。 - 測試反向策略
如果在低 MVRV 時買入賺錢,那可以再試試高 MVRV 賣出,看看是否能夠賺錢,證明邏輯多空皆可行。
如只有單邊可行,那就要思考該預測因子出現以上表現是否合理。 - 細調參數
找出「參數高原」的亮區,在該區間內測試更細的數字。
比如原本的「參數高原」在 10 天至 200 天,以 10 為間隔的表現不錯,那就重做一次回測,並改為 5 天甚至 1 天作間隔。 - 分年檢查
將原始數據拆分為不同年份,如 2020 至 2023 年的數據拆分為 2020、2021、2022、2023年,然後再分別跑四次回測。
這樣做是觀察策略在不同時間段的表現,策略表現與最佳參數是否顯著變動 。
如果每年的最佳參數都有極大差異,那直接使用 2020 至 2023 年數據找出的最佳參數,也可能會出問題。
未來, lo2cin4bt 會增加「 walk-forward analysis 」,幫助各位更簡單地檢查策略穩定性。 - 資金曲線的表現
有些時候,策略跑贏買入並持有策略的原因,僅僅是逃過了一兩次的大跌。
這些是運氣還是預測因子真的能夠預測大跳並及時離場?
◉ 量化新手小秘訣
最後想分享一個很重要的散戶量化開發思路:
我認為只要足夠優質的數據,只需用簡單策略便可獲利。
交易者該多花時間尋找策略靈感和數據,而非擺弄指標。
尤其是如無必要,別增加指標。
愈嚴格的規則只會提高過擬合風險,保持反脆弱。
◉ 加入量化交易終身會籍
對量化交易充滿熱情但缺乏經驗?歡迎了解我們的終身會籍,與 40 位以上會員一起探索交易的無限可能!
在會員群中,你可以:
- 隨時提問,例如「我的交易策略為什麼沒效果?」
- 一同研究相同策略的參數變化是否合理
- 學習其他量化愛好者分享的實用策略,快速上手試驗。
- 結識志同道合的夥伴,共同成長、交流量化交易心得。
立即加入,和我們一起打造屬於你的量化交易旅程!